「亂碼」是 Java 開發者的噩夢。本文從 String 內存模型 出發,系統梳理 編解碼核心 API、表單/URL 編碼差異、亂碼逆向恢復原理,並提供生產級 encodeURL/decodeURL 工具類,徹底解決網絡傳輸編碼難題。
String 內部以 UTF-16 (char[]) 存儲,每個字符 2 字節(補充字符用代理對 4 字節)。byte[]);「解碼」= 字節序列 → Unicode。
// 編碼:String → byte[] (指定 charset)
byte[] gbkBytes = str.getBytes("GBK");
byte[] utf8Bytes = str.getBytes("UTF-8");

// 解碼:byte[] → String (指定 charset)
String s1 = new String(gbkBytes, "GBK");
String s2 = new String(utf8Bytes, "UTF-8");
鐵律:編碼與解碼 charset 必須一致,否則產生亂碼或數據損壞。
URLEncoder.encode(value, charset)。URLDecoder.decode(value, charset) 解碼。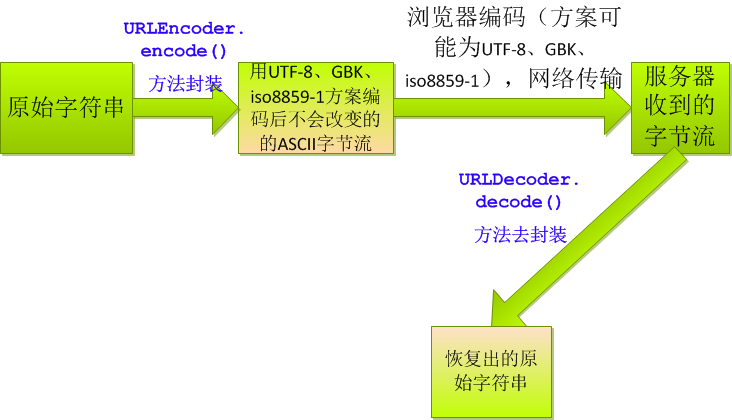
URLEncoder.encode 會將 / : ? # 等保留字符全部編碼,導致 URL 結構破壞,服務端 400/404。
正確策略:保留協議、域名、端口、路徑分隔符 /,僅對每個路徑段、查詢參數值 分段編碼。
public class UrlCodec {
    private static final char SEP = '/';

    /** 對 URL 路徑部分分段編碼,保留 / */
    public static String encodeURL(String url, String charset) {
        try {
            StringBuilder sb = new StringBuilder(url.length() * 2);
            int start = 0;
            for (int i = 0; i < url.length(); i++) {
                if (url.charAt(i) == SEP) {
                    sb.append(URLEncoder.encode(url.substring(start, i), charset));
                    sb.append(SEP);
                    start = i + 1;
                }
            }
            if (start < url.length()) sb.append(URLEncoder.encode(url.substring(start), charset));
            return sb.toString();
        } catch (UnsupportedEncodingException e) { throw new RuntimeException(e); }
    }

    /** 對應解碼 */
    public static String decodeURL(String url, String charset) {
        try {
            StringBuilder sb = new StringBuilder(url.length());
            int start = 0;
            for (int i = 0; i < url.length(); i++) {
                if (url.charAt(i) == SEP) {
                    sb.append(URLDecoder.decode(url.substring(start, i), charset));
                    sb.append(SEP);
                    start = i + 1;
                }
            }
            if (start < url.length()) sb.append(URLDecoder.decode(url.substring(start), charset));
            return sb.toString();
        } catch (UnsupportedEncodingException e) { throw new RuntimeException(e); }
    }

    /** 處理含 host 的完整 URL (https://host:port/path) */
    public static String encodeURLAfterHost(String url, String charset) {
        int idx = url.indexOf(SEP); // http: 第一個 /
        if (idx < 0) return encodeURL(url, charset);
        idx++; // 過掉 /
        if (idx < url.length() && url.charAt(idx) == SEP) { // https://
            idx++; // 過掉第二個 /
            idx = url.indexOf(SEP, idx); // 找第三個 / (host 結束)
            if (idx > 0) {
                return url.substring(0, idx + 1) + encodeURL(url.substring(idx + 1), charset);
            }
            return url; // 無路徑
        }
        return encodeURL(url, charset);
    }
    // decodeURLAfterHost 邏輯對稱
}
場景:GBK 字節流被錯誤按 ISO-8859-1 解碼成 String,再按 ISO-8859-1 編碼回字節,最後按 GBK 解碼 — 可完全恢復。
原理:ISO-8859-1 (Latin-1) 將單字節 0x00-0xFF 直接映射到 Unicode U+0000-U+00FF,是無損單字節透傳編碼。
但 UTF-8 字節流含多字節字符時,錯誤按 ISO-8859-1 解碼會產生無法還原的 Unicode 字符(因 UTF-8 多字節序列被拆解為多個獨立 Latin-1 字符,重組失敗)。
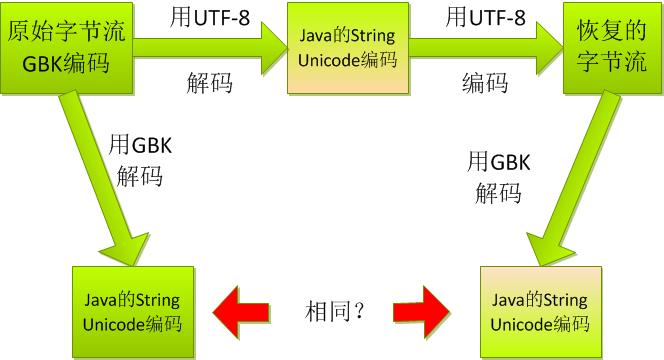
// 核心邏輯:str.getBytes(trueCharset) -> new String(bytes, wrongCharset) -> getBytes(wrongCharset) -> new String(bytes, trueCharset)
public static void testEncoding(String str, String trueEnc, String wrongEnc) {
    byte[] trueBytes = str.getBytes(trueEnc);
    String mid = new String(trueBytes, wrongEnc); // 錯誤解碼
    byte[] midBytes = mid.getBytes(wrongEnc);     // 同錯誤編碼回字節
    String restored = new String(midBytes, trueEnc); // 正確解碼
    System.out.println("恢復: " + restored + " | 成功: " + restored.equals(str));
}
-Dfile.encoding=UTF-8)、數據庫、HTTP Header、JS、瀏覽器 <meta charset="utf-8">。URLEncoder.encode。<Connector URIEncoding="UTF-8" useBodyEncodingForURI="true" />。CharacterEncodingFilter 強制 request/response UTF-8。charset="UTF-8"。建立「字節視角」思維:遇到亂碼,先看原始 byte[] 十六進制,再推導編解碼鏈路,方能對症下藥。