CUDA 的並行模型與 CPU 多線程截然不同:將任務劃分為 Grid → Block → Thread 三層階層。矩陣乘法因元素間運算獨立、數據量大,極適合 GPU 加速。本文記錄從版本 0(朴素)到版本 1(共享記憶體分塊)的優化全過程。
void MatrixMulCPU(float* C, const float* A, const float* B,
                  int wa, int ha, int wb) {
    for (int i = 0; i < ha; ++i)
        for (int j = 0; j < wb; ++j) {
            float sum = 0;
            for (int k = 0; k < wa; ++k)
                sum += A[i*wa + k] * B[k*wb + j];
            C[i*wb + j] = sum;
        }
}三層循環,C(i,j) = Σ A(i,k)*B(k,j),運算強度高、無數據相依,極適合並行化。
16x16 = 256 threads(WC/16, HC/16),覆蓋整個輸出矩陣__global__ void matrix_kernel_0(float* C, const float* A, const float* B,
int wa, int wb) {
int row = blockIdx.y * blockDim.y + threadIdx.y;
int col = blockIdx.x * blockDim.x + threadIdx.x;
float sum = 0;
for (int k = 0; k < wa; ++k)
sum += A[row*wa + k] * B[k*wb + col];
C[row*wb + col] = sum;
}缺點: 全域記憶體訪問未合併,同一 warp 內線程讀取 A、B 時地址不連續,頻寬利用率低。
將矩陣劃分為 BLOCK_SIZE x BLOCK_SIZE 子塊。每個 Block 負責計算一個 C 子塊。利用共享記憶體 __shared__ 暫存 A、B 的對應子塊,實現數據重用與合併訪問。
#define BLOCK_SIZE 16

__global__ void matrix_kernel_1(float* C, const float* A, const float* B,
                                int wa, int wb) {
    int bx = blockIdx.x, by = blockIdx.y;
    int tx = threadIdx.x, ty = threadIdx.y;

    // 該 Block 需處理的 A 起始行、B 起始列
    int aBegin = wa * (by * BLOCK_SIZE);
    int aEnd   = aBegin + wa - 1;
    int aStep  = BLOCK_SIZE;

    int bBegin = BLOCK_SIZE * bx;
    int bStep  = BLOCK_SIZE * wb;

    float cSub = 0;

    for (int a = aBegin, b = bBegin; a <= aEnd; a += aStep, b += bStep) {
        // 1. 協作載入:每線程搬運一個元素到共享記憶體
        __shared__ float As[BLOCK_SIZE][BLOCK_SIZE];
        __shared__ float Bs[BLOCK_SIZE][BLOCK_SIZE];
        As[ty][tx] = A[a + wa*ty + tx];
        Bs[ty][tx] = B[b + wb*ty + tx];
        __syncthreads();

        // 2. 計算子塊乘積
        for (int k = 0; k < BLOCK_SIZE; ++k)
            cSub += As[ty][k] * Bs[k][tx];
        __syncthreads(); // 確保共享記憶體不被下輪覆蓋
    }

    // 3. 寫回全域記憶體
    int cIndex = (by*BLOCK_SIZE + ty)*wb + (bx*BLOCK_SIZE + tx);
    C[cIndex] = cSub;
}aBegin/bBegin:Block 對應的 A 子塊行起始、B 子塊列起始。aStep/bStep:跨越下一組子塊的步長。__syncthreads():載入後同步、計算後同步,防止競態。2 * BLOCK_SIZE² * sizeof(float),BLOCK_SIZE=16 時僅 2KB,遠小於 48KB 限制。void matrixMulGPU(float* C, const float* A, const float* B,
int wa, int ha, int wb) {
float *d_a, *d_b, *d_c;
cudaMalloc(&d_a, wa*ha*sizeof(float));
cudaMalloc(&d_b, wb*wa*sizeof(float));
cudaMalloc(&d_c, wb*ha*sizeof(float));
cudaMemcpy(d_a, A, wa*ha*sizeof(float), cudaMemcpyHostToDevice);
cudaMemcpy(d_b, B, wb*wa*sizeof(float), cudaMemcpyHostToDevice);
dim3 threads(BLOCK_SIZE, BLOCK_SIZE);
dim3 blocks(wb/BLOCK_SIZE, ha/BLOCK_SIZE);
matrix_kernel_1<<>>(d_c, d_a, d_b, wa, wb);
cudaDeviceSynchronize();
cudaMemcpy(C, d_c, wb*ha*sizeof(float), cudaMemcpyDeviceToHost);
cudaFree(d_a); cudaFree(d_b); cudaFree(d_c);
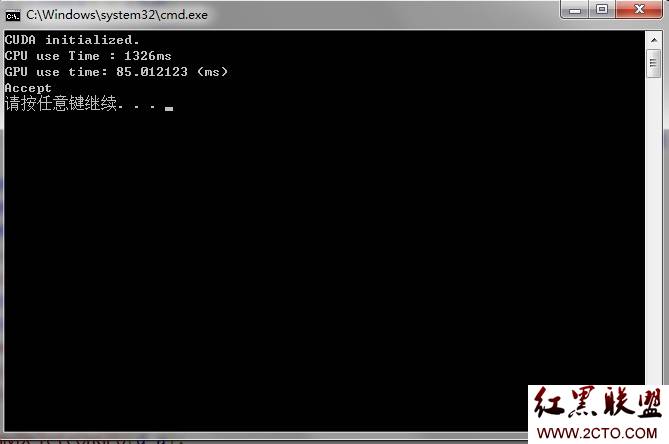
} 
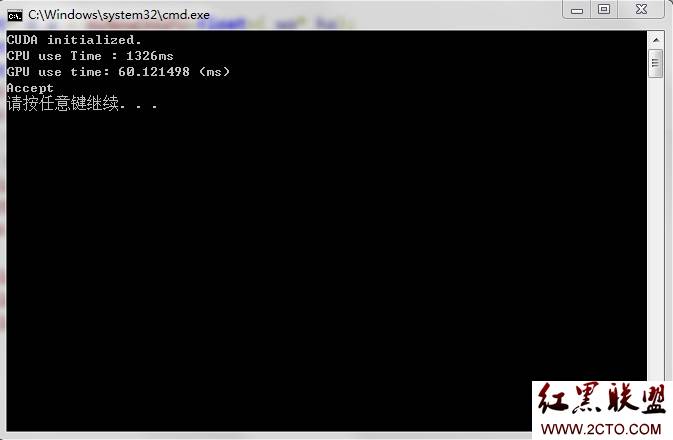
完整驗證主程式(含隨機初始化、誤差檢查、計時)已整合在代碼中,建議親自編譯運行體會加速快感!