對已建索引的列直接套用函數/運算,會導致優化器放棄 Index Seek 轉為 Index Scan,效能隨資料量線性惡化。
-- 年月函數包裹索引列 → 全索引掃描
SELECT * FROM Sales.SalesOrderHeader
WHERE YEAR(OrderDate) = 2005 AND MONTH(OrderDate) = 7
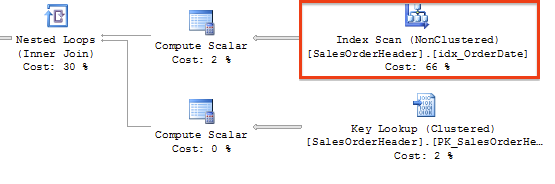
雖有 Non-Clustered Index on OrderDate,優化器仍選擇 Scan。
-- 等價範圍查詢 → Index Seek + Range Scan
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate >= '20050701' AND OrderDate < '20050801'
原則:函數/運算移至常數側,保持索引列「乾淨」。
| 反模式 (導致 Scan) | 修正模式 (Seek 友善) | 說明 |
|---|---|---|
| CAST(CreditCardID AS CHAR(4)) = '1347' | CreditCardID = CAST('1347' AS INT) | 轉型移至常數 |
| ISNULL(Col, 0) = 5 | Col = 5 OR Col IS NULL | 展開邏輯 |
| Col + 1 = 10 | Col = 9 | 代數變換 |
| SUBSTRING(Name, 1, 3) = 'ABC' | Name LIKE 'ABC%' | 前綴匹配可 Seek |
| DATEDIFF(day, CreateDate, GETDATE()) < 7 | CreateDate > DATEADD(day, -7, GETDATE()) | 時間運算移常數側 |
Col_Computed AS (YEAR(OrderDate)) PERSISTED 再建索引,查詢直接用計算欄可 Seek。WHERE VarcharCol = 123 觸發隱式轉換 CONVERT(INT, VarcharCol),同樣導致 Scan。嚴禁隱式轉換。OPTION (RECOMPILE) 或 OPTIMIZE FOR 處理。>= 且 < 而非 BETWEEN(避免邊界歧義)?'ABC%' 可 Seek,'%ABC'/'%ABC%' 必 Scan)?UPDATE STATISTICS 或自動更新)?「索引列不加工」是 SQL 效能調優的第一鐵律。將運算下推至常數側,讓優化器發揮 B+樹導航優勢,是從 Scan 到 Seek 的關鍵一步。