需求:依 DepartmentId 排序後,取 Name 不重複值並保留排序順序。直接 SELECT DISTINCT Name ... ORDER BY DepartmentId 報錯;子查詢排序後再 DISTINCT 因 DISTINCT 內部排序導致順序錯亂。本文分析根因並提供 ROW_NUMBER 解法。
-- 錯誤:ORDER BY 項目必須出現在 SELECT 清單
SELECT DISTINCT Name FROM Sample ORDER BY DepartmentId;

-- 子查詢嘗試
SELECT DISTINCT a.Name FROM (SELECT TOP 100 PERCENT Name FROM Sample ORDER BY DepartmentId) a;
-- 結果順序錯誤,因 DISTINCT 會重新排序
DISTINCT 執行計畫包含 Sort Distinct 操作,強制對結果排序去重ORDER BY 在外層 DISTINCT 排序前被忽略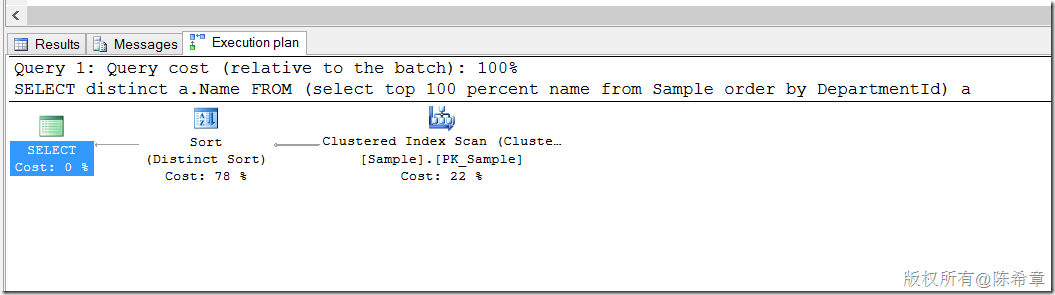
SELECT a.Name FROM (
    SELECT TOP 100 PERCENT
        Name, DepartmentId,
        ROW_NUMBER() OVER (PARTITION BY Name ORDER BY DepartmentId) AS rn
    FROM Sample
    ORDER BY DepartmentId
) a
WHERE a.rn = 1
ORDER BY a.DepartmentId;
PARTITION BY Name 為每個 Name 分組ORDER BY DepartmentId 組內依部門排序ROW_NUMBER() 給每組第一筆編號 1rn = 1 保留每組首筆 → 達到去重且保留首次出現順序ORDER BY DepartmentId 恢復全域排序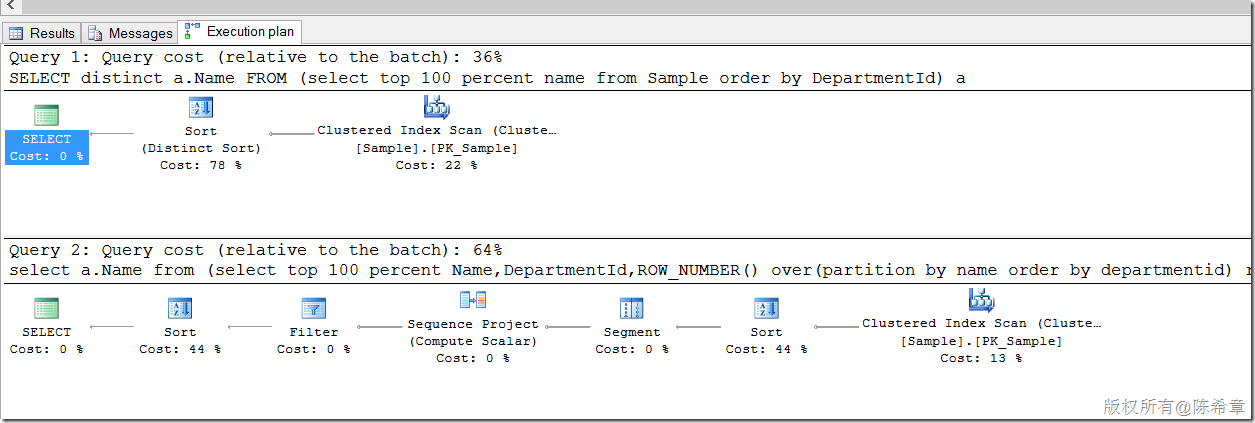
Segment → Sequence Project → Filter(Name, DepartmentId) 覆蓋索引優化GROUP BY Name HAVING MIN(DepartmentId) → 需再 JOIN 回表取 Name,同樣複雜理解 DISTINCT 內部排序特性,靈活運用視窗函數,能解決看似簡單實則棘手的排序去重需求。