Oracle 開發者習慣變量綁定提升效能,MySQL 是否同理?作者設計嚴謹對照實驗,測試 PREPARE/EXECUTE 與直接執行在有/無 Query Cache 情況下的效能差異,得出反直覺結論。
| 維度 | 設置 |
|---|---|
| 環境 | MySQL 5.1.57 (Windows, 免安裝版) |
| 測試表 | MyTable(DictID BIGINT PRIMARY KEY, ...),含測試資料 |
| 查詢模式 | 100 條 LIMIT offset, 100 分頁查詢,offset 1~10000,無重複 |
| 測試腳本 A | 直接執行 100 條 SELECT DictID FROM MyTable LIMIT n, 100 |
| 測試腳本 B | PREPARE s1 FROM 'SELECT DictID FROM MyTable LIMIT ?,?'; EXECUTE s1 USING @offset, @limit; 循環 100 次 |
| 度量方式 | SET PROFILING=1; 從 information_schema.PROFILING 取得每語句 DURATION |
| 控制變因 | 每輪前重啟 MySQL 清除 Query Cache;交換執行順序(A→B / B→A) |
SET PROFILING=1;
SELECT * FROM MyTable WHERE DictID = 100601000004;  -- 預熱開表
SELECT DictID FROM MyTable LIMIT 1, 100;
SELECT DictID FROM MyTable LIMIT 2, 100;
... (至 LIMIT 100, 100)
SELECT QUERY_ID, SEQ, STATE, 10000*DURATION
FROM INFORMATION_SCHEMA.PROFILING
INTO OUTFILE 'd:/NormalResults.csv' FIELDS TERMINATED BY ',' LINES TERMINATED BY '\n';SET PROFILING=1;
SELECT * FROM MyTable WHERE DictID = 100601000004; -- 預熱
SET @stmt = 'SELECT DictID FROM MyTable LIMIT ?,?';
PREPARE s1 FROM @stmt;
SET @s = 100; SET @s1 = 101; ... SET @s100 = 200;
EXECUTE s1 USING @s1, @s;
EXECUTE s1 USING @s2, @s;
... (至 @s100)
SELECT QUERY_ID, SEQ, STATE, 10000*DURATION
FROM INFORMATION_SCHEMA.PROFILING
INTO OUTFILE 'd:/StmtResults.csv' FIELDS TERMINATED BY ',' LINES TERMINATED BY '\n';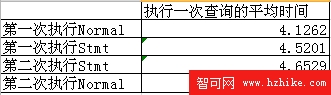
| 場景 | Normal 直接執行 | Stmt 預處理 | 差異 |
|---|---|---|---|
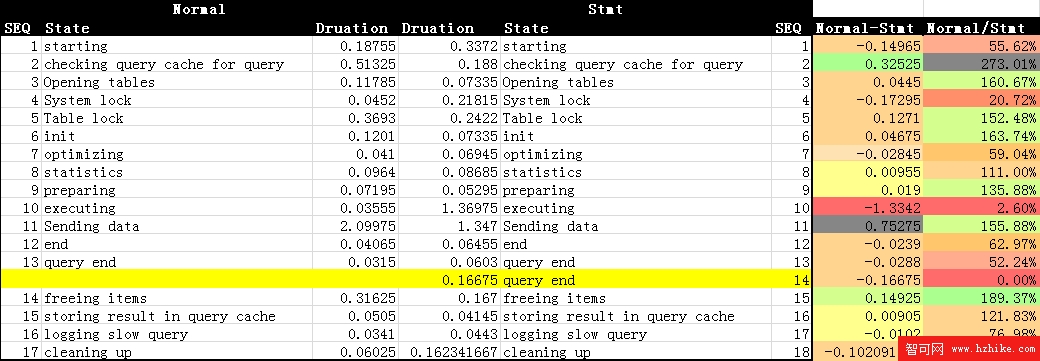
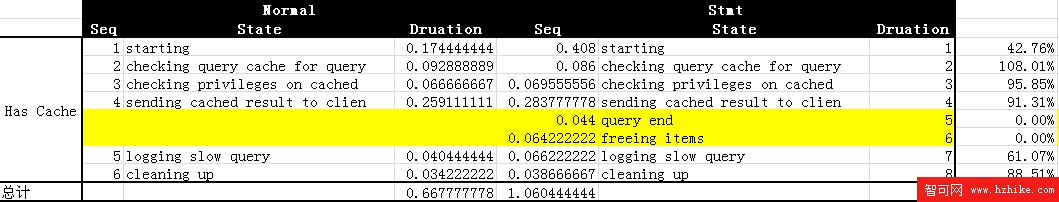
| 無 Cache(重啟後) | ~1200 | ~1450 | 預處理 慢 20% | 有 Cache(第二輪) | ~300 | ~420 | 預處理 慢 40% |
PREPARE 解析、優化、生成執行計畫;EXECUTE 參數綁定、再次驗證權限。直接執行合併為單步。EXECUTE 仍需完整優化流程。PREPARE、EXECUTE 各需一次網路往返,直接執行僅一次。PROFILING 細分顯示:EXECUTING 階段預處理明顯較長,抵消了 OPTIMIZING 微小優勢。| 場景 | 優勢來源 | 適用版本 |
|---|---|---|
| 應用層複用 PreparedStatement 物件 | 避免重複傳送 SQL 文本、客戶端解析開銷 | 所有版本 (JDBC/PDO/Mysqli) | 高併發相同 SQL、參數不同 | 減少網路封包大小、解析 CPU | 所有版本 |
| 防止 SQL 注入 | 參數化查詢語義級防護 | 所有版本 |
| 查詢計畫快取命中 | 避免重複優化 | MySQL 8.0+ (有限支援) |
PREPARE/EXECUTE **不提升、反而降低** 單語句執行效能。實驗數據與分析已打包:MySQL預處理實驗結果.rar。歡迎大牛指正、補充新版本行為差異。