program_Access_log:4,000 萬筆,約 30GBid,索引 program_id原查詢:
SELECT * FROM program_Access_log
WHERE program_id BETWEEN 1 AND 4000;
加上 id BETWEEN 1 AND 500000 後速度無提升,甚至更慢。
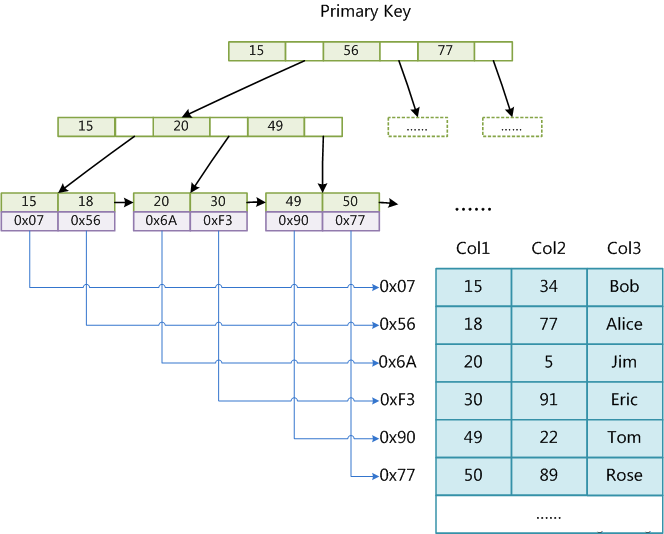
program_id 範圍小(4000),被選為驅動索引program_id 索引掃出的 ID 為離散分佈-- 擴大 program_id 範圍,使其選擇度降低,優化器轉而選擇主鍵 id
SELECT * FROM program_Access_log
WHERE id BETWEEN 1 AND 500000
AND program_id BETWEEN 1 AND 15000000;結果:主鍵範圍掃描變為順序讀取,IO 從隨機變順序,速度提升數十倍。
| 策略 | 適用場景 | 實施難度 |
|---|---|---|
| 分區表 | MySQL 5.1+,按 program_id RANGE 分區 | 中(需重建表) |
| 分表 | 業務邏輯可按時間/租戶拆分 | 高(應用層改造) |
| 覆蓋索引 | 查詢欄位少,建立 (program_id, id, 其他欄位) | 低 |
| 強制索引 | 應急方案 FORCE INDEX (PRIMARY) | 極低 |
「索引不總是越多越好,關鍵在於訪問模式是否順序。」大表隨機回表是效能殺手,應優先考慮讓查詢走順序掃描,哪怕掃描行數略多。