MySQL(關聯式資料庫)與 Lucene(搜尋引擎核心庫,支撐 Solr/Elasticsearch)同樣依賴索引加速查詢,但底層資料結構、設計哲學與適用場景截然不同。本文從原理層面深度剖析兩者差異。
一、MySQL 索引實現
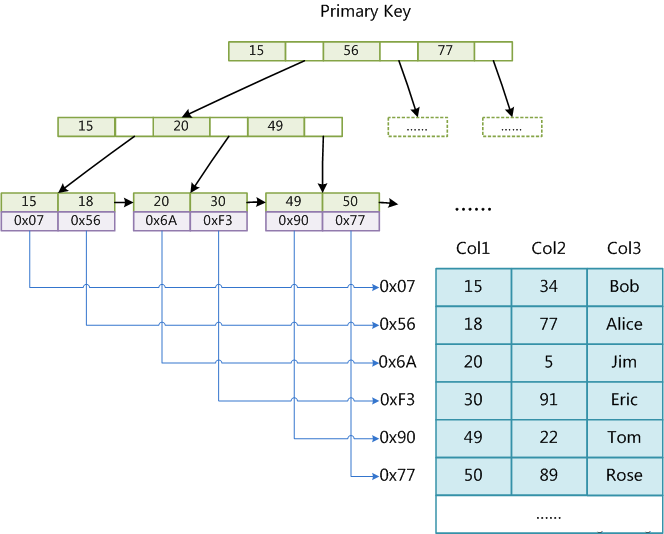
1. MyISAM:非聚集索引
- B+Tree 葉節點存 資料行指標(檔案偏移量)
- 索引檔(.MYI)與資料檔(.MYD)分離
- 主索引與輔助索引結構相同,僅主鍵要求唯一
2. InnoDB:聚集索引
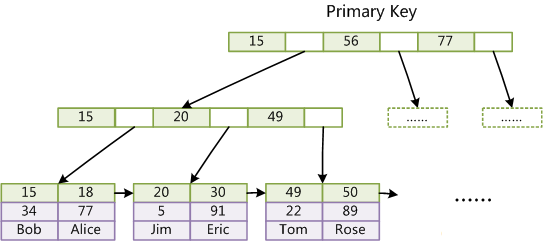
- 資料檔即主索引:表資料按主鍵順序組織在 B+Tree 葉節點
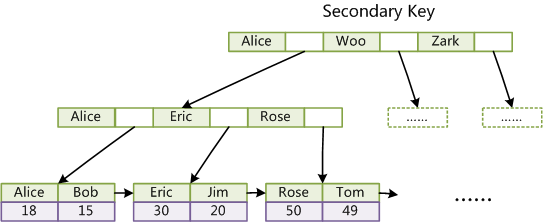
- 輔助索引葉節點存 主鍵值 而非位址,查詢需「回表」兩次 B+Tree 搜尋
- 強制要求主鍵(無則隱式生成 6-byte row_id)
InnoDB 設計啟示
- 主鍵宜短(如自增整數),因所有輔助索引攜帶主鍵值
- 主鍵宜單調遞增,避免 B+Tree 頻繁分裂
- 覆蓋索引可避免回表,大幅提升效能
二、Lucene 倒排索引實現
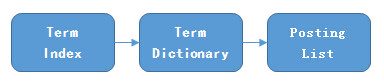
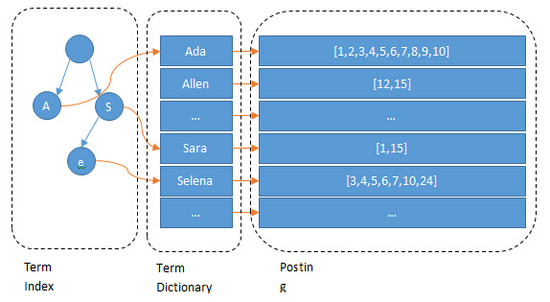
核心三層結構
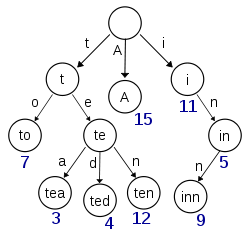
- Term Index:Trie 樹(FST 壓縮),駐留記憶體,快速定位 Term Dictionary 塊
- Term Dictionary:磁碟分 Block 儲存,共用前綴壓縮,有序便於二分查找
- Posting List:符合 Term 的文檔 ID 有序陣列,支援 AND/OR/NOT 集合運算
關鍵優化技術
- FST (Finite State Transducers):Term Index 記憶體佔用極小
- Block 壓縮:共用前綴,磁碟空間效率遠超 B+Tree
- 多型索引:數值用 TrieIntField、地理座標用 GeoHash
- 任意組合:多欄位 AND/OR 直接合併 Posting List,無需建立聯合索引
三、核心差異對照表
| 維度 | MySQL (B+Tree) | Lucene (倒排索引) |
|---|
| 資料導向 | 行導向(記錄為單位) | 列/詞導向(Term 為單位) |
| 查詢模式 | 精確匹配、範圍、前綴、排序 | 全文檢索、關鍵字組合、相關性排序 |
| 多欄查詢 | 需建立聯合索引,遵循最左前綴 | 任意欄位組合即時合併 Posting List |
| 記憶體友好 | 熱點頁面緩存於 Buffer Pool | Term Index (FST) 全量駐留記憶體 |
| 寫入代價 | 隨機 I/O 維護 B+Tree 平衡 | 段合併,批次順序寫入,近實時 |
| 典型場景 | OLTP、結構化查詢、事務處理 | 全文搜尋、日誌分析、非結構化資料 |
四、總結
MySQL B+Tree 適合結構化、事務性、精確/範圍查詢;Lucene 倒排索引專為全文檢索、多維組合、高壓縮、近實時寫入設計。兩者互補而非替代,現代架構常「MySQL 寫入 + Binlog 同步至 Elasticsearch」雙寫滿足不同查詢需求。