utf8_general_ci 不分大小寫)。<charset>_<rule>_ci/cs/bin。| 變量 | 角色 |
|---|---|
| character_set_server | 內部操作預設字符集 |
| character_set_client | 客戶端發送資料編碼 |
| character_set_connection | 連接層編碼 (client→connection 轉換目標) |
| character_set_results | 結果集返回編碼 |
| character_set_database | 當前庫預設字符集 |
| character_set_system | 元數據字符集 (固定 UTF-8) |
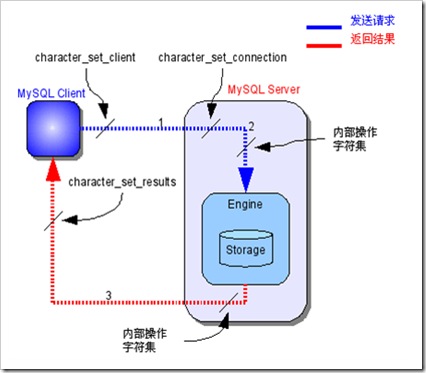
latin1 → latin1 → utf8,每漢字 3 字節 → 6 字節落盤。utf8 → utf8 原封返回 6 字節 → 亂碼。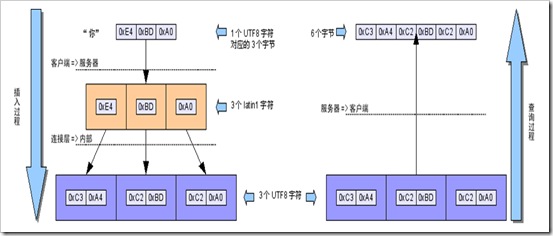
utf8 → utf8 → latin1,超出 Latin1 範圍字符 (如中文) 強制轉 0x3F (?),**資料永久遺失**。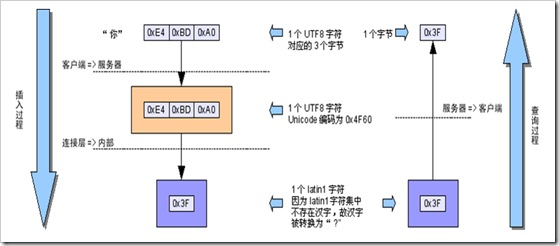
SHOW CHARACTER SET;
SHOW COLLATION;
SHOW VARIABLES LIKE 'character%';
SHOW VARIABLES LIKE 'collation%';
SELECT HEX(col), LENGTH(col), CHAR_LENGTH(col), CHARSET(col), COLLATION(col) FROM tbl;
HEX 看實際位元組,LENGTH 位元組長,CHAR_LENGTH 字符長,比值 = 平均字節/字符。CHARSET()/COLLATION() 確認欄位實際屬性。utf8mb4,不信賴預設。utf8mb4,支援 Emoji,避免補充字符截斷。mysql_options(MYSQL_SET_CHARSET_NAME, "utf8mb4");PHP 每請求 SET NAMES utf8mb4;長連接重連後必重發。my.cnf default-character-set **僅影響命令列客戶端**,應用層無效。_utf8mb4'中文' 強制編碼,避免隱式轉換驚喜。字符集問題本質是**編碼不一致的多次轉換導致資訊損失**。建立「顯式配置、全鏈路 utf8mb4、驅動層自動化、HEX 驗證」標準化流程,可從架構層面根治亂碼。