許多開發者只知道 GROUP_CONCAT(col) 將分組內的值用逗號連接,卻忽略了它支援 ORDER BY、DISTINCT、SEPARATOR 等強大子句。本文以實例示範如何在聚合時直接完成組內排序與去重,省去應用層二次處理。
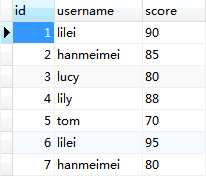
假設表 t1:
+----------+-------+
| username | score |
+----------+-------+
| Alice    |  85   |
| Alice    |  92   |
| Bob      |  78   |
| Bob      |  78   |  -- 重複分數
| Bob      |  88   |
+----------+-------+
SELECT
    username,
    GROUP_CONCAT(DISTINCT score ORDER BY score DESC SEPARATOR ' | ') AS scores
FROM t1
GROUP BY username;
關鍵點:
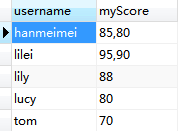
DISTINCT:組內去重,Bob 的 78 只出現一次。ORDER BY score DESC:組內降序,高分在前。SEPARATOR ' | ':自定義分隔符,預設逗號。+----------+-----------------+ | username | scores | +----------+-----------------+ | Alice | 92 | 85 | | Bob | 88 | 78 | +----------+-----------------+
| 需求 | 寫法 | 注意 |
|---|---|---|
| 多欄位拼接 | GROUP_CONCAT(CONCAT(course, ':', score) ORDER BY score DESC) | 先 CONCAT 再聚合 |
| 超長結果被截斷 | 調大 group_concat_max_len(預設 1024 位元組)SET SESSION group_concat_max_len = 1000000; | 需在查詢前設定,或改用應用層分頁聚合 |
| NULL 值處理 | 預設忽略 NULL;若需保留用 COALESCE(score, 'N/A') | |
| 配合窗口函數 (8.0+) | GROUP_CONCAT(score) OVER (PARTITION BY username ORDER BY score DESC) | 不需 GROUP BY,保留明細行 |
GROUP_CONCAT 需在記憶體中構建字串,大量資料易觸發 tmp_table_size 限制導致磁碟臨時表,影響效能。JSON_ARRAYAGG(5.7+)輸出 JSON 陣列再由前端處理。GROUP BY 欄位與 ORDER BY 欄位有合適索引(如 INDEX idx_user_score (username, score DESC)),可避免 filesort。善用 GROUP_CONCAT 的完整語法,能將「查詢+排序+去重+格式化」壓縮在單一 SQL 完成,減少網路傳輸與應用層代碼,是報表類查詢的利器。