正如房屋、車輛、寵物乃至人際關係都需要悉心照料才能保持良好狀態,資料庫管理系統(DBMS)亦不例外。若疏於維護,DBMS 將面臨碎片化、效能退化,最終因運營成本居高不下而被迫停用。保持維護版本最新以享受技術紅利固然重要,但正確應用維護技術才是降低成本的核心。本文將深入探討透過系統維護、工具善用及細節把控,從五大維度降低 DB2 運營成本的實戰策略。
產生相同結果的查詢路徑往往不止一條,關鍵在於找到最能發揮 DBMS 長處的那一條。這聽起來簡單,實則充滿挑戰,因為可用工具與技術隨時間快速演進。
數年前,某客戶接手一個遷移至 DB2 for z/OS V8 的 CRM 應用。其中一個程式每日佔用 System z9 全部 CPU 週期的 25%,內含 10 個 CREATED Global Temporary Tables,其中 6 個嵌套在遞歸 SQL 中,行數隨銷售鏈深度在 1 萬至 10 萬之間波動,且被反覆訪問。
DB2 for z/OS 另提供 DECLARED Global Temporary Table。DB2 9 之前,CREATED 臨時表無法使用索引,而 DECLARED 表卻可建立聚簇索引。建議將那 6 個大表改為帶聚簇索引的 DECLARED 表,其餘 4 個小表因單次訪問保持不變。改動後,單筆事務耗時從 1.78 秒暴跌至 0.07 秒,考慮到日均 6,000 次執行,每日節省 2.8 CPU 小時,效果驚人,資深 DBA 甚至開玩笑要退貨新採購的 z9。
時移至今,DB2 9 已能對反覆訪問的工作檔案(含臨時表)自動生成稀疏索引。但優化機會隨時湧現。SQL 是「移動的靶子」:1983 年誕生時僅支援內連接、子查詢、GROUP BY 等基礎功能與約 21 個內建函數;歷經 27 年演進,DB2 9 for z/OS 的 SQL 特性已極其豐富(見側邊欄「DB2 SQL 已成熟」)。
DB2 SQL 已成熟
從最初的寥寥功能,發展至今涵蓋:TABLE EXPRESSIONS、COMPLEX CORRELATION、GLOBAL TEMPORARY TABLES、CASE、100+ BUILT-IN FUNCTIONS、LIMITED FETCH、SCROLLABLE CURSORS、UNION EVERYWHERE、MIN/MAX SINGLE INDEX SUPPORT、SELF REFERENCING UPDATES WITH SUBQUERIES、SORT AVOIDANCE FOR ORDER BY、ROW EXPRESSIONS、2M STATEMENT LENGTH、GROUP BY EXPRESSION、SEQUENCES、SCALAR FULLSELECT、MATERIALIZED QUERY TABLES、COMMON TABLE EXPRESSIONS、RECURSIVE SQL、CURRENT PACKAGE PATH、VOLATILE TABLE SUPPORT、STAR JOIN SPARSE INDEX、QUALIFIED COLUMN NAMES、MULTIPLE DISTINCT CLAUSES、IS NOT DISTINCT FROM、ON COMMIT DROP、TRANSPARENT ROWID COLUMN、GET DIAGNOSTICS、STAGE1 UNLIKE DATA TYPES、MULTI-ROW INSERT、MULTI-ROW FETCH、DYNAMIC SCROLLABLE CURSORS、MULTIPLE CCSIDS PER STATEMENT、ENHANCED UNICODE、PARALLEL SORT、TRUNCATE、DECIMAL FLOAT、VARBINARY、OPTIMISTIC LOCKING、FETCH CONTINUE、MERGE、CALL FROM TRIGGER、STATEMENT ISOLATION、FOR READ ONLY KEEP UPDATE LOCKS、SET CURRENT SCHEMA、CLIENT SPECIAL REGISTERS、LONG SQL OBJECT NAMES、SELECT FROM INSERT/UPDATE/DELETE/MERGE、INSTEAD OF TRIGGER、NATIVE SQL PROCEDURE LANGUAGE、BIGINT、FILE REFERENCE VARIABLES、XML、FETCH FIRST & ORDER BY IN SUBSELECT AND FULLSELECT、CASELESS COMPARISONS、INTERSECT、EXCEPT、NOT LOGGED TABLES 等數百項特性。
部分特性功能重疊,但大多數提供獨特能力。務必緊跟新特性並充分利用,因許多新特性能顯著提升效能、降低應用運營成本。
搜尋靜態與動態 SQL 關鍵字,可有效衡量生產 SQL 集合的水準。圖 1、2 展示兩家客戶的 SQL 報告卡:
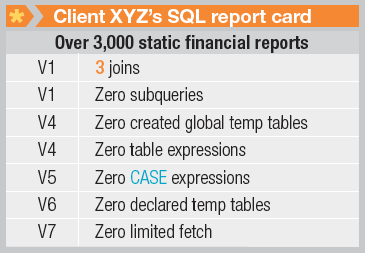
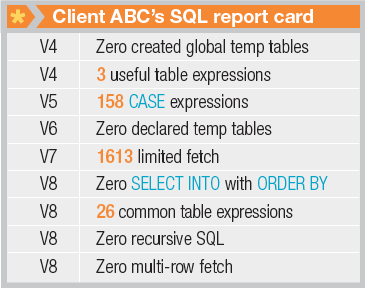
客戶 XYZ 在 3,000 個財務報表應用中僅使用極少 SQL 技術,幾乎所有業務規則與過濾皆靠基礎 SQL 實現,未受惠於高效能 SQL 函數。客戶 ABC 雖較佳,但仍缺乏帶 ORDER BY 的 SELECT INTO 與多行擷取,這兩項特性通常分別能降低 30% 與 50% 的 CPU 需求。遷移至 DB2 9 後,應積極採用 TRUNCATE、MERGE、SELECT FROM UPDATE/DELETE/MERGE、EXCEPT/INTERSECT、RANK/DENSE_RANK/ROW_NUM、子查詢中的 ORDER BY/FETCH FIRST 等新特性,否則被迫依賴外部工具,不僅增加授權成本,更因資料需移出 DB2 處理而嚴重拖累效能。評估 SQL 集合的搜尋機制,同樣可用於驗證待採購應用套件是否運用先進特性。
基礎表索引是預防效能問題的第一道防線。最高頻或最關鍵的事務與服務,必須擁有能支援所有所需連接、過濾、排序任務的適當索引。過濾與連接極度消耗資源,缺索引將重創效能。
某公司提供客戶登入網頁,採用流行的「P-Search」架構:登入時按固定模式執行一系列服務並緩存結果,供後續分頁點擊即時顯示。若服務缺乏適當索引,開銷極大。該服務在 System z10 上 DB2 耗時 9.9 CPU 秒,高峰期客戶等待 10-40 秒。核心是一個動態查詢:TABLEA、TABLEB、TABLEC 三表連接,三表均按單列 SEQEN_NR 分區與聚簇,但其他索引均未包含 SEQEN_NR,迫使優化器在過濾與連接間二選一。
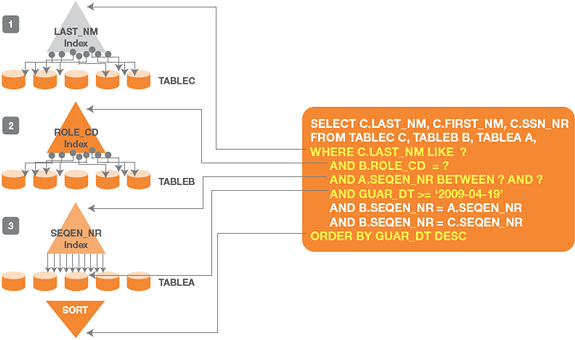
步驟 1:TABLEC 先訪問,優化器套用 LAST_NM 區域過濾,但索引無 SEQEN_NR,需隨機 I/O 取得連接鍵,連接推遲至資料頁面。
步驟 2:TABLEB 套用 ROLE_CD 過濾,同樣隨機 I/O,連接再次推遲。
步驟 3:TABLEA 使用聚簇索引連接,循序 I/O 取資料,套用 GUAR_DT 過濾並 ORDER BY 排序。
三表皆將過濾或連接推遲至資料頁面,根因在於缺乏同時滿足過濾與連接的複合索引。
新索引方案依所有過濾、連接、排序操作組合結構,CPU 時間從 9.9 秒暴跌至 0.02 秒,效能提升近 500 倍。
List Prefetch、Multiple Index Access、Hybrid Join - Type N 等訪問路徑需先完成多步驟再回傳結果,開銷極大。它們透過 RID(行標識符)排序消除隨機 I/O,預先在 RID 池對資料頁面號預排序。RID 池資源有限,超限即觸發表掃描。程式向 RID 池注入的 RID 越多,失效概率越高。現象之一是連續預擷取數量異常飆升。線上監視器是排查利器。圖 4 顯示某使用 Hybrid Join - Type N 的程式一小時內發生 61 次 RID 池失效。
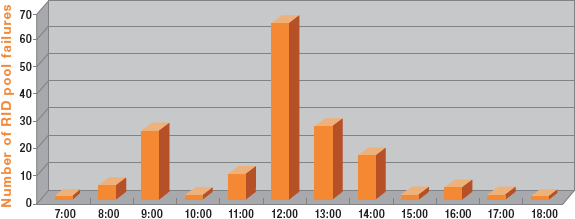
擴大 RID 池只能暫緩,甚至無效。更佳方案:用 DB2 追蹤或線上監視器識別高度依賴 RID 池的查詢。每個查詢必須證明其對 RID 池的使用合理——即能一直擷取至結果集末尾。通不過者,需在查詢末尾加上 OPTIMIZE FOR n ROWS 或 FETCH FIRST n ROWS ONLY 子句,關閉使用 RID 池的訪問路徑。DB2 10 將利用外部工作檔案處理溢出,減輕失效衝擊,但遷移前最好先解決,否則將消耗大量工作檔案。
凍結 SQL 指嵌入購買應用中無法修改的 SQL。這類查詢有時違背效能準則,卻只能忍受。須讓它們消耗最少資源。例:WHERE DATE(col_TS) BETWEEN :date1 AND :date2 是 Stage 2/Residual 條件,應改寫為 WHERE col_TS BETWEEN TIMESTAMP(:date1,'00:00:00') AND TIMESTAMP(:date2,'59:59:99') 成為可用索引的 Stage 1/Sargable,但無法修改。
SELECT DATE(col_TS) AS NEW_COL FROM TABLE 並在 NEW_COL 建索引,所有動態查詢將使用該索引。CREATE INDEX ON DATE(col_TS),單一結構同樣成效,靜態動態查詢皆可用。此技術同適用於開銷巨大、計算複雜或極高頻的非凍結查詢。若站點無法採用上述結構,降低 CPU 需求將無計可施。
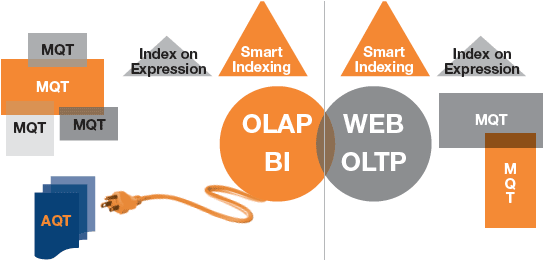
基於記憶體的方案正在醞釀:利用 IBM Data Studio(免費)將事實表與維表預載入記憶體,將數倉部分複製壓縮為完全駐留記憶體的網絡設備,形成加速查詢表 (AQT)。DB2 9 Query Router 將透明重導 INNER/LEFT JOIN 查詢至 AQT。實驗室與 Beta 測試顯示,長查詢可加速 5-10 倍且無需修改應用。MQT、Index on Expression、AQT 將構成智能效能層,支撐可擴展性。
可擴展性要求智能模式設計高效適應工作負載:
組織應深諳自家 DBMS,妥善維護並關注細節。為保持可擴展性,打包的 DB2 應用亦須遵循效能準則。善用適當 SQL、索引、訪問路徑、MQT、表設計與 AQT,遵循這些樸素規則,即能大幅降低資料管理成本。落實需投入時間精力,在當今敏捷開發週期中常被忽略,但若視而不見,DBMS 很快將不堪重負。