作為記憶體內關聯式資料庫,IBM solidDB 憑藉超快速度與超高可用性贏得全球青睞。顧名思義,記憶體內資料庫完全駐留主記憶體而非磁碟,使資料存取比傳統磁碟基資料庫快一個數量級。這一飛躍固然源於 RAM 存取速度遠超硬碟,但 solidDB 更擁有專為主記憶體儲存、搜尋、處理資料而設計的資料結構與存取方法。因此,即便傳統磁碟資料庫將資料完全緩存記憶體,solidDB 仍能勝出。部分資料庫雖能提供低延遲,卻難以支撐大量事務或並發會話;solidDB 則能達到每秒數萬至數十萬筆事務吞吐,並始終保持微秒級響應時間(查詢 10-20μs,更新 <100μs),遠優於傳統資料庫的毫秒級表現。
20 世紀 60 年代資料管理系統誕生時,磁碟驅動器是唯一能在合理時間儲存、存取大量資料的媒介。RDBMS 設計者專注優化 I/O、安排資料存取模式以適配驅動器塊結構,策略常圍繞共享緩衝池,演進出 B+ 樹等塊優化索引。查詢優化策略著眼於極小化頁面讀取,在效能爭奪戰中磁碟 I/O 是最大敵人,為避免磁碟存取常犧牲處理效率——典型 8/16 KB 頁面的頁內處理屬循序本質,CPU 效率低於隨機存取,卻是減少磁碟訪問的主流做法。
記憶體豐裕時代來臨,DBA 不斷擴大緩衝池直至容納整個資料庫,催生「全緩存資料庫」概念。但 DBMS 仍受累於面向塊的 I/O 策略,這套邏輯原本是為硬碟設計的,在 RAM 中顯得低效。
記憶體內資料庫最顯著的差異在於沒有大塊資料結構。solidDB 消除了塊,表列與索引節點獨立儲存記憶體,直接新增資料無需重組大塊結構。並摒棄大塊索引(叢生樹),轉向精簡結構:增加索引層數、最小化索引節點、避免節點內處理成本。常見記憶體索引策略為 T-樹,但 solidDB 採用 Trie(前綴樹/字典樹),最初為文本搜尋設計,最終成為極佳記憶體索引策略。
Trie(源於 retrIEval)由節點系列組成,給定節點的後代共享相同字串前綴。例如「dog」存為節點,它是含「do」節點的後代,後者又是含「d」節點的後代。索引包含小型指標陣列,指向更低層。搜尋時鍵值被分割為小塊(數個位元),每塊直接作為相應層陣列的索引:最左塊指向第一層,第二塊指向第二層,以此類推。僅需幾次陣列元素檢索即完成搜尋。每個索引節點約 256 位元組,完美契合現代處理器緩存,極大提升處理器效率。這類小型資料陣列是現代處理器最高效資料結構,solidDB 大量運用以極大化效能。
solidDB 專利檢查點方法產生快照一致性檢查點,同時不阻塞正常事務處理。資料庫僅需從單一檢查點重啟,其他產品通常需用事務日誌重算一致狀態(solidDB 允許必要時關閉日誌記錄)。關鍵在於分配列鏡像與列影子鏡像(同一列不同版本),無需低效塊結構。僅與一致性快照相符的鏡像寫入檢查點檔案,列影子讓當前執行事務在檢查點建立期間無限制運行。
solidDB 查詢優化器以全新方式估算執行成本,辨別記憶體內表的不同特性。優化聚焦 CPU-bound 執行路徑,而全緩存資料庫仍專注優化取頁到大容量儲存的操作——這在記憶體內已非問題。
傳統資料庫堅持完全持久性,保證提交時寫入資料永久不變,但導致同步日誌寫、消耗資源、降低響應速度。許多場景下,為換取更快響應,接受較短持久性極具價值。solidDB 允許對給定資料庫會話乃至整個事務在運行時放寬持久性。
solidDB 提供含完整查詢執行代碼的資料庫存取驅動程式,開發人員可將應用與 DBMS 代碼鏈接,利用共享記憶體在應用間共享資料,避免進程上下文切換開銷。
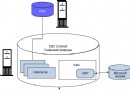
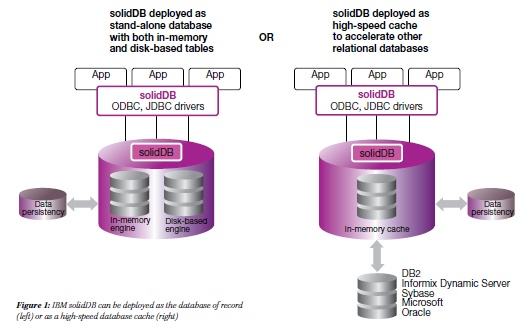
綜合上述措施,當應用負載大到使傳統資料庫產生大量 I/O 時,solidDB 吞吐率提升數量級,響應速度提升更驚人:查詢事務延遲 10-20μs,更新事務 <100μs,傳統資料庫通常以毫秒計。除效能優勢,solidDB 還將完全事務性記憶體內資料庫與強大磁碟基資料庫融合於緊湊方案,透明實現同一資料庫部分駐留記憶體、部分駐留磁碟。更是市場上唯一可作為幾乎任何磁碟基關聯資料庫前端高速緩存部署的產品(見圖 1)。並提供超高可用性,將可用時間從傳統 5 個 9 (99.999%) 提升至 99.9999%。尋求極速者將找到 solidDB,但這只是開始。