Sidekick 是數位行銷公司 HubSpot 旗下產品,專責在郵件被打開時即時通知發送者。其通知管道完全建構於 Apache Kafka 之上。Sidekick 基礎設施資深工程師 Ze'ev Klapow 分享了他們如何監控 Kafka 消費者性能,快速定位問題。
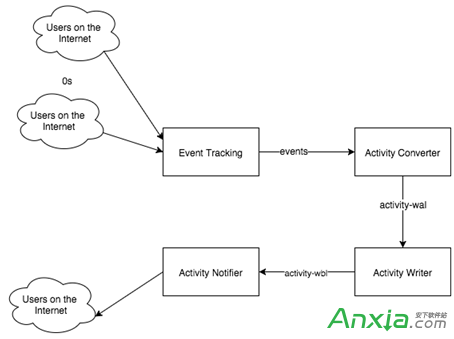
架構中多個 Kafka 消費者串聯運作,必須監控每個消費者的處理能力,並在異常發生時迅速定位根因。為此,團隊開發了兩大核心指標:增量(Delta) 與 延遲(Lag)。
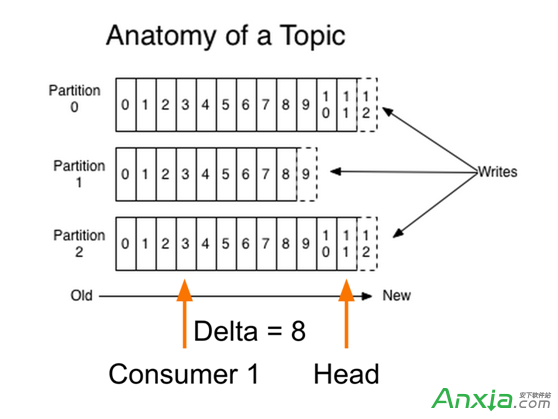
Kafka 中每條訊息寫入分區時獲得遞增的位移。消費者記錄已消費的最後位移。增量 = 分區最新位移 - 消費者當前位移,反映消費者落後多少訊息。
對每個消費者,團隊追蹤兩個增量維度:
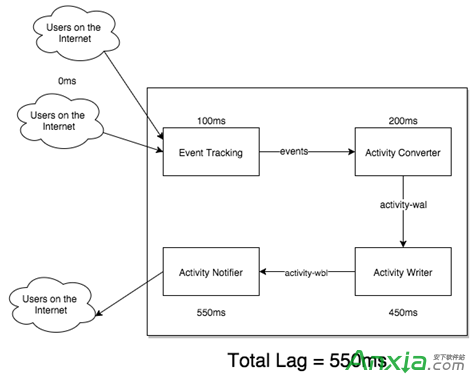
Sidekick 在每條訊息附加時間戳記。總延遲 = 事件建立時間到通知發送時間的差值,涵蓋整個管道處理鏈路。
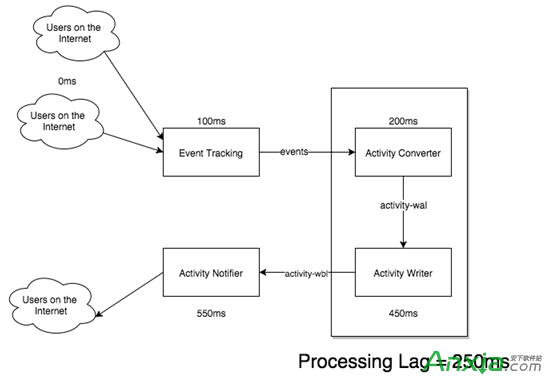
進一步拆解各階段延遲(如佇列等待、處理耗時、網路傳輸),當總延遲異常時,可快速定位具體環節。
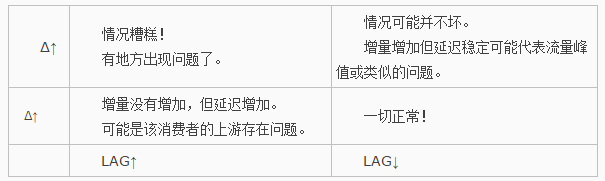
Ze'ev 指出,這張表格在事故發生時能指引排查方向;平時則讓團隊對系統健康度充滿信心。兩大指標結合,提供了系統健康的完整視圖。
HubSpot 通過 增量(追趕能力) 與 延遲(時效性) 兩大維度,構建了 Kafka 消費者監控體系,實現了從「發現問題」到「定位根因」的高效閉環,值得大規模流式處理系統參考借鑑。