亂碼是開發者常遇到的痛點。本文從字元、字元集、字元編碼的基本概念切入,詳細比較 ASCII、GB2312、GBK、Big5、GB18030、Unicode、UTF-8 等常見編碼的特點與差異,並透過實際程式碼示範不同編碼間轉換的結果,幫助徹底理解亂碼產生的根本原因。
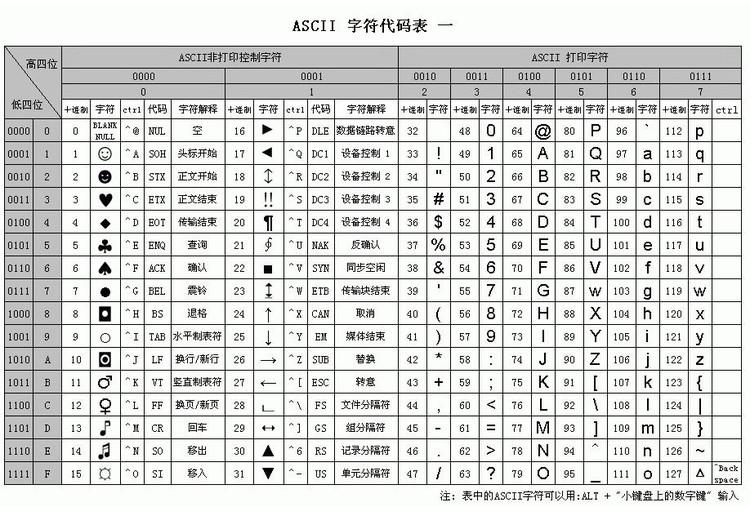
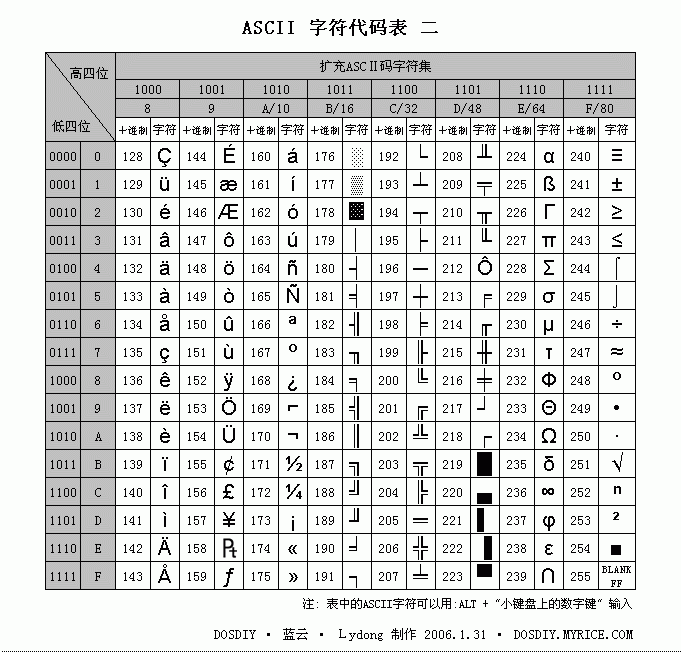
單位元組編碼,僅包含 128 個字符(擴展後 256 個),僅支援英文字母、數字及基本符號,無法表示中文等非英文字符。
Unicode 為全球統一字元集,每個符號擁有唯一碼位,固定 4 位元組儲存(UTF-32),空間浪費大。
UTF-8 是 Unicode 的變長實現方式:英文字母 1 位元組,常用漢字 3 位元組,極少用字 4 位元組,節省空間且相容 ASCII,成為網路傳輸主流。
UTF-8 編碼規則:
1) 單位元組符號:最高位 0,後 7 位為 Unicode 碼。
2) n 位元組符號 (n>1):第一位元組前 n 位為 1,第 n+1 位為 0,後續位元組前兩位皆為 10,剩餘位填 Unicode 碼。
不同編碼間無法完全相容。例如以 UTF-8 編碼的資料若以 GB2312 解碼,位元組序列對應錯誤字符,產生亂碼。好比雙方說不同語言,強行對話自然無法理解。
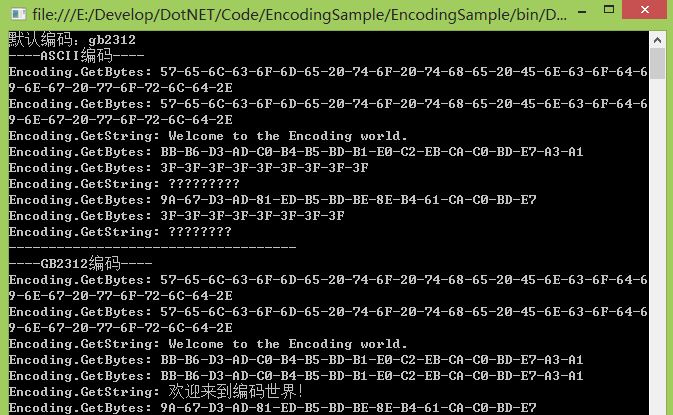
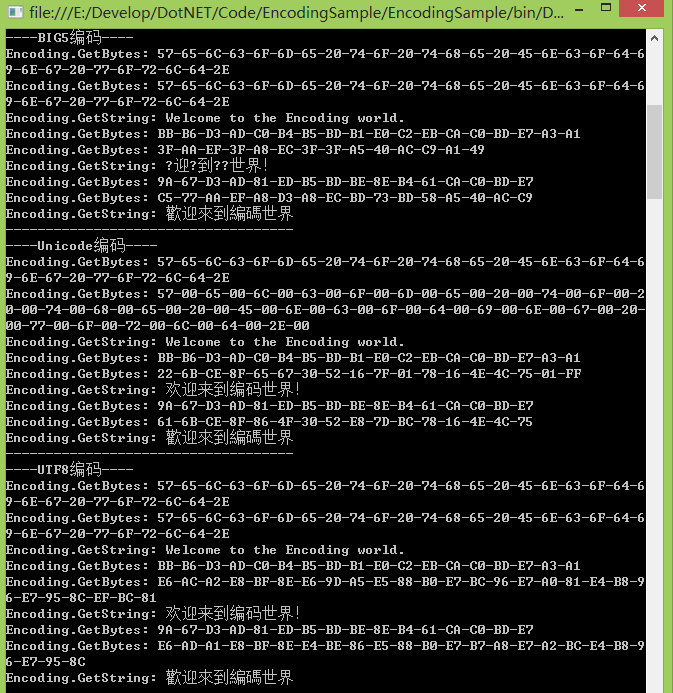
以下程式碼展示同一組字串(英文、簡體、繁體)在 ASCII、GB2312、Big5、Unicode、UTF-8 等編碼下的位元組表示與轉換結果:
using System;
using System.Text;

namespace EncodingSample {
    class Program {
        static void Main(string[] args) {
            string str_en = "Welcome to the Encoding world.";
            string str_cn = "歡迎來到編碼世界!";
            string str_tw = "歡迎來到編碼世界";
            Encoding defaultEncoding = Encoding.Default;
            Console.WriteLine("預設編碼:{0}", defaultEncoding.BodyName);

            TestEncoding(Encoding.ASCII, "ASCII", defaultEncoding, str_en, str_cn, str_tw);
            TestEncoding(Encoding.GetEncoding("GB2312"), "GB2312", defaultEncoding, str_en, str_cn, str_tw);
            TestEncoding(Encoding.GetEncoding("BIG5"), "BIG5", defaultEncoding, str_en, str_cn, str_tw);
            TestEncoding(Encoding.Unicode, "Unicode", defaultEncoding, str_en, str_cn, str_tw);
            TestEncoding(Encoding.UTF8, "UTF8", defaultEncoding, str_en, str_cn, str_tw);
            Console.ReadKey();
        }

        static void TestEncoding(Encoding dstEncoding, string name, Encoding srcEncoding, params string[] strs) {
            Console.WriteLine("----{0}編碼----", name);
            foreach (var s in strs) {
                OutputByEncoding(srcEncoding, dstEncoding, s);
            }
            Console.WriteLine("------------------------------------");
        }

        static void OutputByEncoding(Encoding src, Encoding dst, string srcStr) {
            byte[] srcBytes = src.GetBytes(srcStr);
            Console.WriteLine("原始位元組: {0}", BitConverter.ToString(srcBytes));
            byte[] dstBytes = Encoding.Convert(src, dst, srcBytes);
            Console.WriteLine("目標位元組: {0}", BitConverter.ToString(dstBytes));
            string result = dst.GetString(dstBytes);
            Console.WriteLine("解碼結果: {0}", result);
        }
    }
}