快速排序是經典的分治算法,但遞歸實現容易導致棧溢出,尤其在處理大量數據時。本文介紹一種基於自定義棧結構的非遞歸快速排序實現,經測試可穩定排序 500 萬個整數數據。
傳統遞歸利用系統調用棧保存分區邊界,非遞歸版本則手動維護一個棧結構 BUFF,存儲待排序區間的左右邊界。每次從棧頂取出一個區間進行分區,將產生的子區間壓入棧中,直到棧為空。
typedef struct _BUFF {
    int *LeftBuff;   // 左邊界緩衝區
    int *RightBuff;  // 右邊界緩衝區
    DWORD number;    // 當前棧中元素個數
    struct _BUFF *next; // 擴展塊指針
} BUFF;
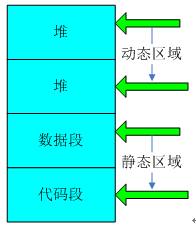
為應對極端情況(如已有序數組導致棧深度過大),採用鏈表式動態擴展:預分配 100 萬個邊界槽位,不足時分配新塊串聯。
採用雙指針法,以區間首元素為基準值 key:
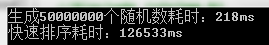
left 從左向右找第一個 ≥ key 的元素right 從右向左找第一個 < key 的元素left >= rightright 位置,完成一次分區int,約 8 MB測試代碼生成 500 萬隨機數,調用 QuickSort 後以 ExamineArr 遍歷驗證有序性。輸出生成耗時與排序耗時,便於性能分析。
摘自 kevinshq 的專欄