傳統遞歸歸並排序「自頂向下」分解。非遞歸版採用**迭代疊加**策略:
step = 1:視為 n 個長度 1 的有序子陣列,兩兩合併。step *= 2:合併長度 2 的子陣列。step >= n,整個陣列有序。優點:無遞歸棧開銷,邏輯清晰易於並行化 (不同區塊獨立合併)。
#include <windows.h> // DWORD
#include <string.h>  // memcpy
#include <stdlib.h>  // malloc/free

void MergeSort(int * const arr, const DWORD number)
{
    if (number < 2) return;

    DWORD i, index1, index2, tmpIndex1, tmpIndex2, step;
    int *tmpArr = (int *)malloc(number * sizeof(int));
    if (!tmpArr) { printf("緩存分配失敗\n"); return; }

    for (step = 1; step < number; step *= 2)
    {
        index1 = 0;
        index2 = index1 + step;
        tmpIndex1 = tmpIndex2 = 0;
        i = 0;

        // 遍歷所有配對區塊
        while ((index2 + tmpIndex2) < number)
        {
            // 合併兩個有序區塊 [index1, index1+step) 和 [index2, index2+step)
            while ((tmpIndex1 < step) && (tmpIndex2 < step) && ((index2 + tmpIndex2) < number))
            {
                if (arr[index1 + tmpIndex1] <= arr[index2 + tmpIndex2])
                    tmpArr[i++] = arr[index1 + tmpIndex1++];
                else
                    tmpArr[i++] = arr[index2 + tmpIndex2++];
            }

            // 複製剩餘元素
            while (tmpIndex1 < step)
                tmpArr[i++] = arr[index1 + tmpIndex1++];

            while ((tmpIndex2 < step) && ((index2 + tmpIndex2) < number))
                tmpArr[i++] = arr[index2 + tmpIndex2++];

            // 移動到下一組區塊
            index1 += 2 * step;
            index2 += 2 * step;
            tmpIndex1 = tmpIndex2 = 0;
        }

        // 將臨時陣列拷回原陣列 (或雙緩衝交換指針優化)
        memcpy(arr, tmpArr, number * sizeof(int));
    }

    free(tmpArr);
}
#include <stdio.h>
#include <stdlib.h>
#include <windows.h>

void ExamineArr(const int * const arr, DWORD number)
{
    for (DWORD i = 0, j = 1; j < number; i++, j++)
        if (arr[i] > arr[j]) { printf("錯誤: 第 %u > 第 %u\n", i, j); return; }
    printf("排序驗證通過。\n");
}

int main()
{
    DWORD StartTime, EndTime, i;
    DWORD num = 50000000; // 5000 萬
    int *arr = (int *)malloc(num * sizeof(int));
    if (!arr) { printf("內存分配失敗\n"); return -1; }

    StartTime = GetTickCount();
    for (i = 0; i < num; i++) arr[i] = rand();
    EndTime = GetTickCount();
    printf("生成 %u 隨機數耗時: %u ms\n", num, EndTime - StartTime);

    StartTime = GetTickCount();
    MergeSort(arr, num);
    EndTime = GetTickCount();
    printf("歸並排序耗時: %u ms\n", EndTime - StartTime);

    ExamineArr(arr, num);
    free(arr);
    return 0;
}
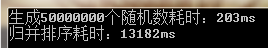
memcpy 全量拷貝開銷),但穩定 O(n log n)。memcpy,交換 arr 與 tmpArr 指針,最後若結果在 tmpArr 再拷回一次。step 較小時 (如 < 32) 改用插入排序,減少函數調用與合併開銷。#pragma omp parallel for)。std::inplace_merge 思路),通常常數因子大,工程較少用。非遞歸歸並排序以**迭代疊加**替代遞歸分解,代碼可控性強、天然適合並行、且**穩定**。雖需 O(n) 額外空間,但在外部排序、大數據處理、需穩定性的場景是首選。掌握其區塊邊界處理 (index2+tmpIndex2 < number) 是寫出無 Bug 代碼的關鍵。