在 Android 中使用 DOM 解析 XML 時,ClassCastException: TextImpl cannot be cast to Element 是高頻錯誤。本文解析其成因,並提供健壯的節點遍歷代碼模式。
開發者嘗試獲取根元素第一個子節點並強轉為 Element:
Node rootElement = n2.item(0);
NodeList child = rootElement.getChildNodes();
Node first = child.item(0); // 此處可能拿到 Text 節點
Element nm = (Element) first; // 拋出 ClassCastException
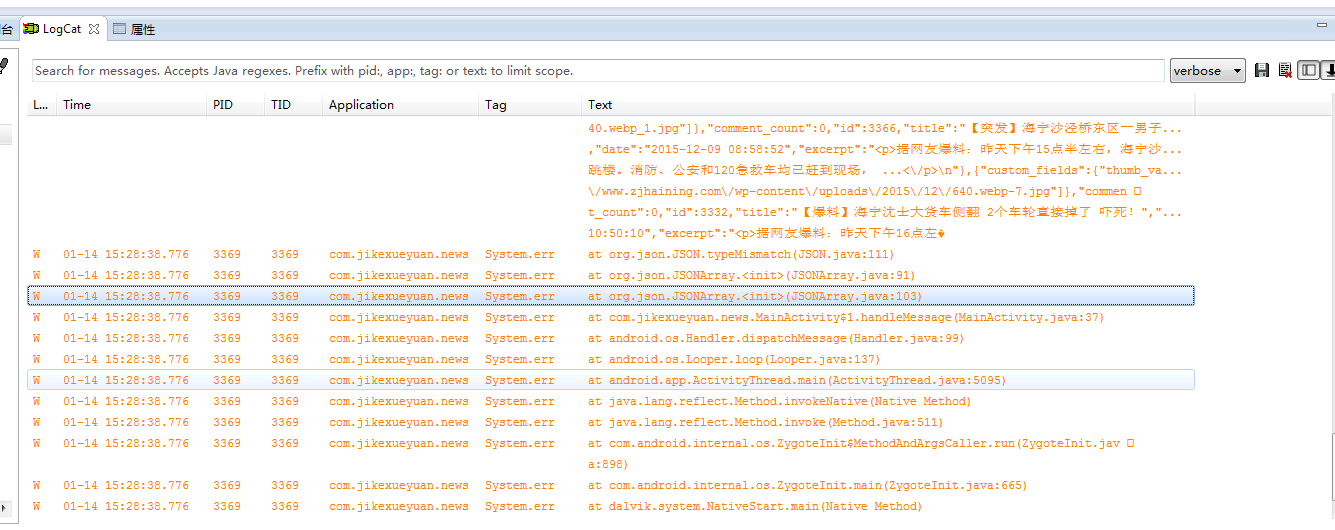
Logcat 明確提示:
java.lang.ClassCastException: org.apache.harmony.xml.dom.TextImpl cannot be cast to org.w3c.dom.Element
XML 解析器會將元素間的換行、縮進、空格解析為 Text 節點(Node.TEXT_NODE)。調用 getChildNodes() 返回的 NodeList 包含所有類型節點(Element、Text、Comment 等),item(0) 往往是第一個空白文本節點,而非預期的子元素。
採用 節點類型檢查 + 標籤名查找 雙重保險:
NodeList topElements = doc.getElementsByTagName("Your_Root_Element");
Node firstTop = topElements.item(0);

if (firstTop.getNodeType() == Node.ELEMENT_NODE) {
    Element root = (Element) firstTop;
    NodeList subNodes = root.getElementsByTagName("Your_Sub_Node");
    if (subNodes.getLength() > 0) {
        Element firstSub = (Element) subNodes.item(0);
        // 安全獲取文本內容
        String text = firstSub.getTextContent();
    }
}
public static Element getFirstChildElement(Element parent, String tagName) {
    NodeList list = parent.getElementsByTagName(tagName);
    return (list.getLength() > 0) ? (Element) list.item(0) : null;
}

// 使用示例
Element item = getFirstChildElement(root, "item");
if (item != null) {
    String name = item.getTextContent();
}
getChildNodes() 返回的首個節點是 Element。getElementsByTagName() 直接按標籤名查找,自動過濾文本節點。getNodeType() == Node.ELEMENT_NODE 判斷。遵循此模式,徹底杜絕 Text 節點導致的類型轉換崩潰。