資料表中出現重複列是常見問題。SQL Server 2008 提供多種刪除重複資料的寫法,本文示範四種常見做法、執行計畫比較,並針對大量重複資料提出最佳化策略。
CREATE TABLE dbo.Employee (
    [Id] int PRIMARY KEY,
    [Name] varchar(50), [Age] int, [Sex] bit DEFAULT 1
);
INSERT INTO Employee VALUES
(1,'James',25,1),(2,'James',25,1),(3,'James',25,1),
(4,'Lisa',24,0),(5,'Lisa',24,0),(6,'Lisa',24,0),
(7,'Mirsa',23,0),(8,'Mirsa',23,0),(9,'Mirsa',23,0),
(10,'John',26,1),(11,'Abraham',28,1),(12,'Lincoln',30,1);DELETE FROM Employee
WHERE Name IN (SELECT Name FROM Employee GROUP BY Name HAVING COUNT(Name) > 1);DELETE T FROM (
SELECT ROW_NUMBER() OVER(PARTITION BY [Name] ORDER BY (SELECT 0)) AS RowNumber, *
FROM Employee
) T WHERE T.RowNumber > 1;WITH Dups AS (
SELECT ROW_NUMBER() OVER(PARTITION BY [Name] ORDER BY (SELECT 0)) AS rn
FROM Employee
)
DELETE FROM Dups WHERE rn > 1;WITH Dups AS (
SELECT [ID],[Name],[Age],[Sex],
ROW_NUMBER() OVER(PARTITION BY [Name] ORDER BY (SELECT 0)) AS rn,
RANK() OVER(PARTITION BY [Name] ORDER BY (SELECT 0)) AS rnk
FROM Employee
)
DELETE FROM Dups WHERE rn <> rnk;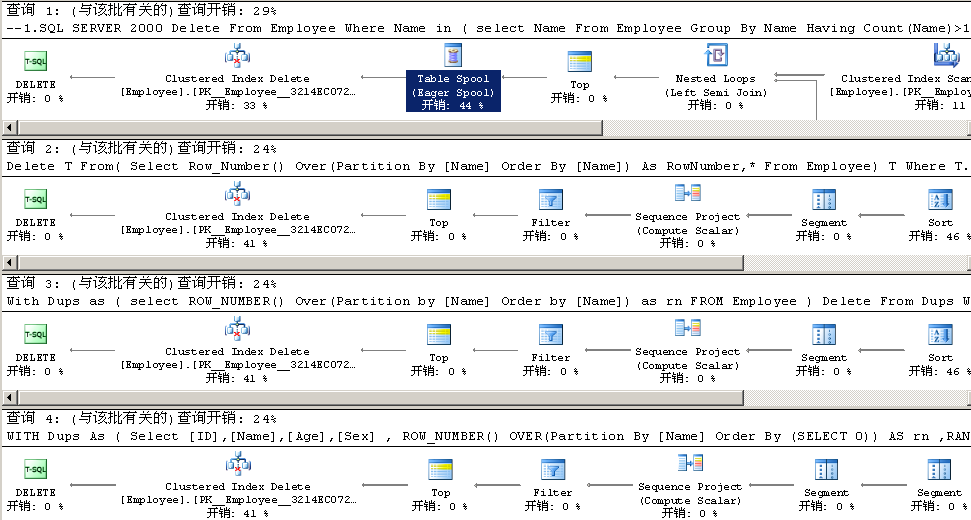
當重複筆數極大時,DELETE 會產生大量交易記錄並鎖定資源。建議採用 「建新表 → 寫入去重資料 → 刪舊表 → 改名」 模式:
WITH Dups AS (
    SELECT [ID],[Name],[Age],[Sex],
           ROW_NUMBER() OVER(PARTITION BY [ID] ORDER BY (SELECT 0)) AS rn
    FROM Employee
)
SELECT [ID],[Name],[Age],[Sex]
INTO dbo.EmployeeDupsTmp
FROM Dups WHERE rn = 1;

DROP TABLE dbo.Employee;
EXEC sp_rename 'dbo.EmployeeDupsTmp', 'Employee';
優點:最小化交易記錄、避免長時間鎖定、可搭配 BULK LOGGED 復原模式進一步減少記錄量。