目標:將單次查詢讀取的資料頁數降至最低。
| 規則 | 說明 | 範例 |
|---|---|---|
| 明確列出欄位 | 禁用 SELECT *,減少 I/O 與網路傳輸 | SELECT Id, Name FROM Users; |
| 高選擇性條件前置 | WHERE 子句中,過濾率高的條件寫在前面 | WHERE Status=1 AND CreateDate>'2023-01-01' |
| 善用索引覆蓋 | SELECT 欄位全部包含在非叢集索引中,避免鍵查找 | CREATE INDEX IX_Users_Cover ON Users(Status) INCLUDE(Name, Email); |
| 存在性檢查用 EXISTS | 勿用 COUNT(*) > 0,EXISTS 遇第一筆即停止 | IF EXISTS (SELECT 1 FROM Orders WHERE CustID=@CustID) |
| 內層限定原則 | 子查詢/衍生表中盡早套用篩選條件 | 見下方「子查詢優化」 |
| 避免 ORDER BY 運算式 | ORDER BY YEAR(DateCol) 導致排序無法用索引 | 改用計算欄位+索引 |
| 反模式 (非 SARGable) | 優化寫法 (SARGable) | 原因 |
|---|---|---|
WHERE Salary*2 > 10000 | WHERE Salary > 5000 | 欄位參與運算導致索引失效 |
WHERE DeptID <> 10 | WHERE DeptID < 10 OR DeptID > 10 | <> 無法尋找,改用範圍 |
WHERE SUBSTR(Name,1,3)='ABC' | WHERE Name LIKE 'ABC%' | 函數導致掃描,LIKE 開頭固定可用索引 |
WHERE Name LIKE '%ABC' | 全文檢索 / 反向索引 / 計算欄位 | 前置萬用字元無法用 B-tree 索引 |
WHERE Name LIKE @var + '%' | WHERE Name BETWEEN @var AND @var + CHAR(255) | 變數導致參數化失敗,BETWEEN 可用索引 |
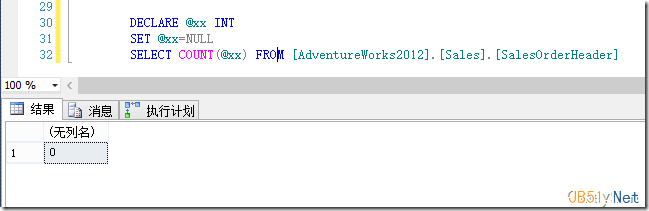
WHERE Col IS NULL | 設計為 NOT NULL + DEFAULT | NULL 不進索引(過濾索引除外) |
WHERE FirstName+' '+LastName='John Doe' | WHERE FirstName='John' AND LastName='Doe' | 串聯運算破壞索引 |
WHERE ID IN (1,2,3) | 拆分為多條 OR 或 UNION ALL | IN 列表常轉為「OR 策略」產生臨時表 |
索引 (Col1, Col2, Col3) 僅以下 WHERE 能有效使用:
WHERE Col1=@v1 AND Col2=@v2 AND Col3=@v3WHERE Col1=@v1 AND Col2=@v2WHERE Col1=@v1跳過 Col1 直接查 Col2、Col3 將導致索引掃描。
-- 原始
SELECT EmpID FROM Emp WHERE DeptID IN (SELECT DeptID FROM Dept WHERE DeptNo='001');
-- 優化 (DeptID 唯一)
SELECT e.EmpID FROM Emp e JOIN Dept d ON e.DeptID=d.DeptID WHERE d.DeptNo='001';
-- 優化 (DeptID 不唯一)
SELECT e.EmpID FROM Emp e JOIN (SELECT DISTINCT DeptID FROM Dept WHERE DeptNo='001') d ON e.DeptID=d.DeptID;
SELECT e.EmpID FROM Emp e
LEFT JOIN Dept d ON e.DeptID=d.DeptID AND d.DeptNo='001'
WHERE d.DeptID IS NULL;
-- 原始:各部門薪資高於平均者
SELECT * FROM Salary a
WHERE a.Amount > (SELECT AVG(b.Amount) FROM Salary b WHERE b.DeptID=a.DeptID);

-- 優化:預先聚合
SELECT a.* FROM Salary a
JOIN (SELECT DeptID, AVG(Amount) AS AvgAmt FROM Salary GROUP BY DeptID) b
  ON a.DeptID=b.DeptID
WHERE a.Amount > b.AvgAmt;
-- 未參數化:每次不同值產生新計畫,污染 Plan Cache
SELECT * FROM Orders WHERE OrderID = 1001;
SELECT * FROM Orders WHERE OrderID = 1002;

-- 參數化:單一計畫重用
DECLARE @OrderID INT = 1001;
SELECT * FROM Orders WHERE OrderID = @OrderID;
-- 或使用 sp_executesql
EXEC sp_executesql N'SELECT * FROM Orders WHERE OrderID = @ID', N'@ID INT', @ID=1001;
實測:1000 次迴圈查詢,參數化後編譯時間從 18 秒降至 0.56 秒。
-- 兩次查詢:先檢查再決定 INSERT/UPDATE
IF NOT EXISTS (SELECT 1 FROM Item WHERE ID=@ID) INSERT ... ELSE UPDATE ...

-- 單次 UPSERT (SQL Server 2008+ MERGE 或 OUTPUT 子句)
UPDATE Item SET Qty=Qty-@Qty WHERE ID=@ID;
IF @@ROWCOUNT=0 INSERT INTO Item (ID, Qty) VALUES (@ID, -@Qty);
業務邏輯確定無重複時,UNION ALL 省去排序去重成本。
UPDATE STATISTICS 或啟用 AUTO_UPDATE_STATISTICS。ALTER INDEX ... REBUILD;10-30% → REORGANIZE。sys.dm_db_index_usage_stats 找出未使用索引並移除。| 等待類型 | 可能原因 | 對策 |
|---|---|---|
PAGEIOLATCH_SH/EX | 磁碟 I/O 瓶頸 | 增加記憶體、優化查詢減少讀取、SSD/分離資料檔 |
LCK_M_* | 封鎖/死結 | 縮短交易、調整隔離等級、索引優化減少掃描 |
RESOURCE_SEMAPHORE | 查詢記憶體授予不足 | 調高 max server memory、優化查詢計畫、Resource Governor |
CXPACKET | 平行查詢負載不均 | 調整 MAXDOP、Cost Threshold for Parallelism |
WRITELOG | 記錄檔寫入延遲 | 記錄檔放獨立快速磁碟、檢查自動增長設定 |