最常用的聚合函數 COUNT 三種寫法到底有何不同?本文從**運算邏輯**、**執行計畫**、**索引選擇機制**三維度徹底釐清,打破「COUNT(1) 比 COUNT(*) 快」的迷思。
COUNT(運算式) 會逐列評估運算式,**非 NULL 才計數**。
COUNT(*):特殊語法,直接計算列數,**不評估任何欄位值**,永遠等於資料表列數。COUNT(1) / COUNT('abc') / COUNT(常數):常數運算式永遠非 NULL,**結果等同 COUNT(*)**。COUNT(欄位):評估該欄位值,**NULL 不計數**,非 NULL 計數。等同 SUM(CASE WHEN col IS NOT NULL THEN 1 ELSE 0 END)。DECLARE @xx INT = NULL;
SELECT COUNT(@xx) FROM Sales.SalesOrderHeader; -- 結果 0(所有列運算式皆 NULL)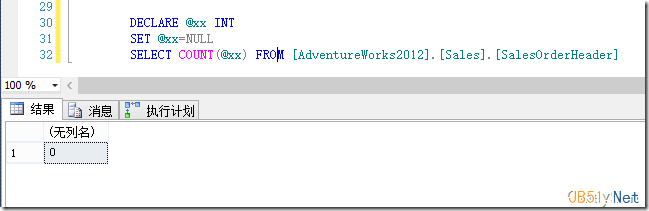
SELECT COUNT(*), COUNT(1), COUNT('anything') FROM Sales.SalesOrderHeader; -- 結果完全相同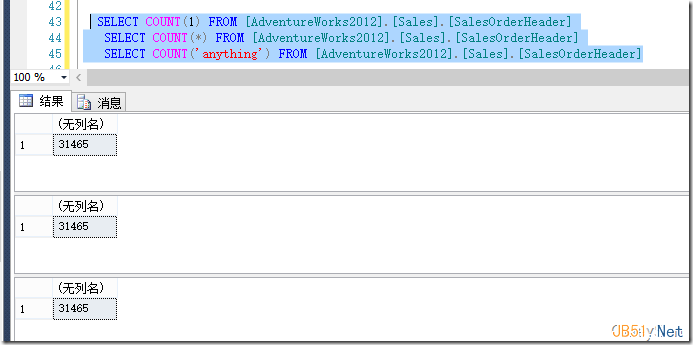
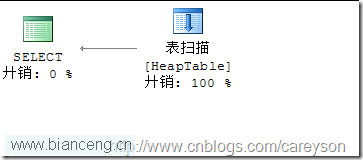
最佳化器需找出**「非 NULL 列數」**。策略:
環境:Person.Address 表,移除所有非叢集索引。
ModifiedDate (DATETIME, 8 bytes) 索引 → 執行計畫使用此索引。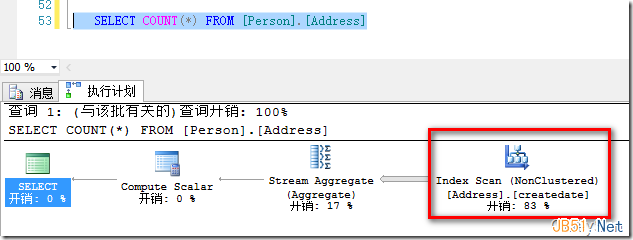
StateProvinceID (INT, 4 bytes) 索引 → **最佳化器自動切換至更窄的 INT 索引**。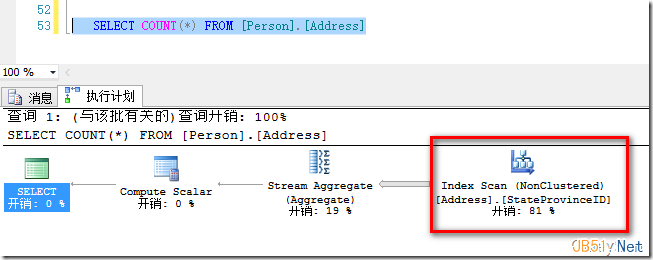
COUNT(*)(ANSI 標準、語意明確)。COUNT(*) 查詢表:**建立單一最窄 NOT NULL 欄位索引**(如 INT、BIGINT、CHAR(1)),大幅降低 I/O。COUNT(可為 NULL 欄位) 需評估 NULL 語意,不可混淆為列數統計。sys.dm_db_partition_stats.row_count 或 TABLESAMPLE。| 寫法 | 語意 | 執行計畫 | 適用場景 |
|---|---|---|---|
COUNT(*) | 資料表列數(標準) | 掃描最窄 NOT NULL 索引 | 通用列數統計 |
COUNT(1) | 等同 COUNT(*) | 同上 | 個人習慣,無優勢 |
COUNT(col) | col 非 NULL 列數 | 掃描 col 索引或鍵查找 | 特定欄位非空計數 |