面對主從表關聯查詢在億級資料下時快時慢、最長達數分鐘的效能難題,本文完整記錄從執行計畫分析、讀寫分離嘗試、硬體升級、專家諮詢,到最終採用「冗余欄位 + 覆蓋索引」方案實現秒級查詢的完整優化歷程,深度解析組合索引欄位順序、排序方向、INCLUDE 欄位三大關鍵要素對效能的決定性影響。
資料量:主表 zhubiao、子表 zibiao 均達億級,更新頻率極高。
原始 SQL:
SELECT TOP 1000
    a.word, a.queryurl, a.irank, a.title, a.baiduurl,
    a.itraffic1, a.itraffic2, b.ibaiduindex
FROM zibiao a WITH(NOLOCK)
INNER JOIN zhubiao b WITH(NOLOCK) ON a.word = b.word
WHERE a.queryurl = 'https://zhidao.baidu.com'
ORDER BY b.ibaiduindex DESC, a.irank;
症狀:執行時間從「瞬間」到「數分鐘」不等,極不穩定。
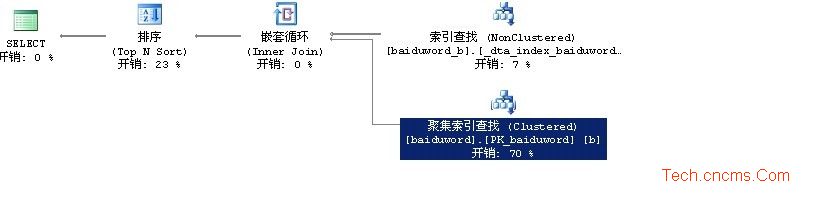
子表依 queryurl 篩選後,需回主表查找 ibaiduindex 進行排序,主表聚集索引查找佔據 90%+ 成本,且因高頻更新導致索引碎片嚴重、統計資訊過期,造成計畫不穩定。
irank 排序秒開(有索引),證明子表篩選非瓶頸。專家建議將主表排序欄位 ibaiduindex 冗余至子表,消除 JOIN 與回表查找。優化後 SQL:
SELECT TOP 1000
    a.word, a.queryurl, a.irank, a.title, a.baiduurl,
    a.itraffic1, a.itraffic2, a.ibaiduindex
FROM zibiao a WITH(NOLOCK)
WHERE a.queryurl = 'https://zhidao.baidu.com'
ORDER BY a.ibaiduindex DESC, a.irank;
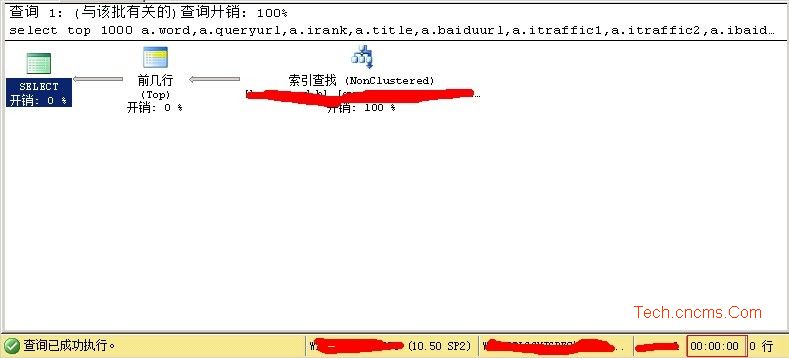
結果:單一非聚集索引查找,無排序運算子,瞬間回傳。
CREATE NONCLUSTERED INDEX IX_zibiao_queryurl_ibaiduindex_irank
ON zibiao (queryurl, ibaiduindex, irank)
INCLUDE (word, title, baiduurl, itraffic1, itraffic2);
queryurl 置首:等值篩選,選擇性最高,縮小掃描範圍。ibaiduindex 其次:ORDER BY DESC 首欄,避免排序運算子。irank 再次:ORDER BY ASC 次欄,配合索引順序直接有序輸出。初始建立時 ibaiduindex ASC 導致仍需 2 秒排序;改為 DESC 後瞬間完成。
鐵律:索引鍵順序與排序方向必須與 ORDER BY 子句逐欄對齊。
將除索引鍵外的所有輸出欄位放入 INCLUDE,使索引成為「覆蓋索引」,查詢完全在索引葉層完成,零回表。
代價:索引體積膨脹數十 GB,但換取查詢穩定秒開,極高性價比。
| 指標 | 優化前 | 優化後 |
|---|---|---|
| 執行時間 | 不穩定,最長數分鐘 | 穩定 < 100ms |
| 執行計畫 | JOIN + 主表聚集索引查找 + 排序 | 單一非聚集索引查找 (Covering) |
| I/O 模式 | 大量隨機讀取 | 順序掃描索引葉層 |
| 維護成本 | 高頻更新導致碎片 | 單表索引維護,無跨表影響 |
ibaiduindex 欄位於子表,預設值 0。UPDATE zibiao SET ibaiduindex = b.ibaiduindex FROM zhubiao b WHERE zibiao.word = b.word。ibaiduindex 同步。REBUILD 覆蓋索引控制碎片。這次優化證明:面對億級高併發查詢,正確的索引設計勝過任何硬體堆疊。掌握「WHERE 排序 覆蓋」三部曲,讓執行計畫為你所用。