早期假設:索引 Seek 時透過 Key Hash Value 快速定位記錄。為驗證此假設,設計實驗比較叢集索引 Seek 與非叢集索引 Seek + RID Lookup 的邏輯讀取數,並嘗試觀察是否讀取所有索引頁面 (若需載入 Hash Bucket)。
USE master;
GO
CREATE DATABASE SCANDB;
GO
USE SCANDB;
GO

CREATE TABLE clusteredtable (c1 INT IDENTITY(1,1), c2 VARCHAR(900));
CREATE TABLE nonclusteredtable (c1 INT IDENTITY(1,1), c2 VARCHAR(900));
GO

CREATE CLUSTERED INDEX cix_clusteredtable ON clusteredtable(c2);
CREATE INDEX ix_nonclusteredtable ON nonclusteredtable(c2);
GO

-- 插入 100 筆,c2 長度 882 字元 (接近 900 上限)
DECLARE @a INT = 1;
WHILE @a <= 100
BEGIN
    INSERT INTO clusteredtable VALUES (CAST(@a AS NVARCHAR(2)) + REPLICATE('a', 880));
    INSERT INTO nonclusteredtable VALUES (CAST(@a AS NVARCHAR(2)) + REPLICATE('a', 880));
    SET @a += 1;
END
GO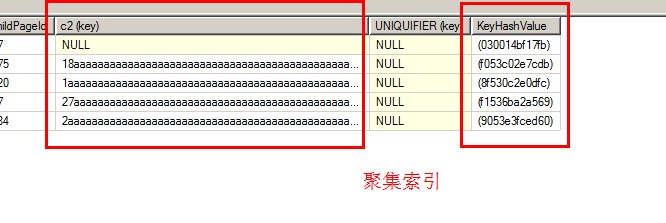
-- 清除緩衝區
CHECKPOINT; DBCC DROPCLEANBUFFERS; DBCC FREESYSTEMCACHE('ALL');

-- 叢集索引 Seek
SET STATISTICS IO ON;
SELECT * FROM clusteredtable WHERE c2 = '18' + REPLICATE('a', 880);
SET STATISTICS IO OFF;
-- 結果:Table 'clusteredtable'. Scan count 1, logical reads 4, physical reads 2

-- 非叢集索引 Seek + RID Lookup
CHECKPOINT; DBCC DROPCLEANBUFFERS; DBCC FREESYSTEMCACHE('ALL');
SET STATISTICS IO ON;
SELECT * FROM nonclusteredtable WHERE c2 = '17' + REPLICATE('a', 880);
SET STATISTICS IO OFF;
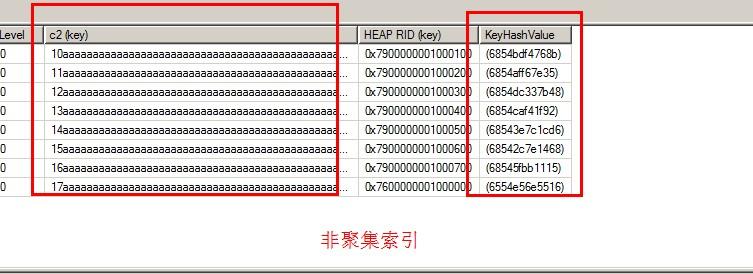
-- 結果:Table 'nonclusteredtable'. Scan count 1, logical reads 5, physical reads 1CREATE TABLE #DBCCResult (...); -- 結構略
INSERT INTO #DBCCResult EXEC ('DBCC IND(SCANDB, nonclusteredtable, -1)');
SELECT * FROM #DBCCResult ORDER BY PageType DESC;
-- 找出 Leaf 頁面編號 (如 Page 89)
DBCC TRACEON(3604, -1);
DBCC PAGE(SCANDB, 1, 89, 3); -- 觀察 Leaf 頁記錄結構初期假設錯誤,公開致歉。科學精神在於實證推翻假設,並將正確認知 (Key Hash = Lock Hash) 傳遞給社群。