目標表 STAT_SUBMIT_CENTER 為範圍分區表(依 MSGDATE 分 50 個分區),總大小 17.2 GB,記錄數 1.7 億筆。需在 RECORDTIME 欄位建立本地索引 IDX_SUBMIT_RECORDTIME。環境:SunOS 5.9, Oracle 9.2.0.4, 8 CPU, 3GB 記憶體。
pga_aggregate_target 從 200MB 提升至 2GB(配合 workarea_size_policy=AUTO,單一 Session 可用 PGA = MIN(5% PGA, 100MB))。NOLOGGING 非線上模式建立,縮短時間窗。-- 1. 擴充暫存檔
ALTER DATABASE TEMPFILE '/bgdata/Oracle/temp01.dbf' RESIZE 8192M;
-- 2. 調大 PGA
ALTER SYSTEM SET PGA_AGGREGATE_TARGET=2048M;
-- 3. 背景執行建立索引腳本
nohup time createind.sh &
-- createind.sh 內容:
#!/bin/sh
sqlplus user/password <監控發現 v$sort_segment.used_blocks 與 v$sort_usage.blocks 呈現「遞增→歸零」的週期性波動,共發生 14 次,對應 14 個較大分區的索引建立過程。每個分區建立時會產生大量暫存段排序,完成後釋放。期間 user_segments 查不到索引段,實際上以系統產生的數字段名暫存,失敗會自動回滾。
總耗時 99 分鐘 完成全部 50 個分區的本地索引建立。
索引建立完成後,必須收集統計資訊,否則優化器可能選擇錯誤存取路徑(如 INDEX FAST FULL SCAN 導致查詢極慢)。
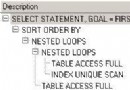
ANALYZE INDEX IDX_SUBMIT_RECORDTIME ESTIMATE STATISTICS;收集前:查詢 RECORDTIME > TRUNC(SYSDATE) 採 INDEX FAST FULL SCAN,11 分鐘無結果。
收集後:優化器轉為 INDEX RANGE SCAN,查詢僅耗 5.37 秒,效能提升超過 100 倍。
DBMS_STATS 並行收集,進一步縮短維護窗口。