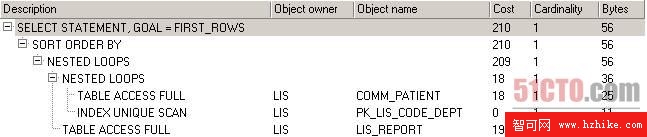
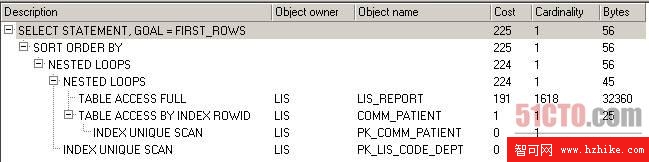
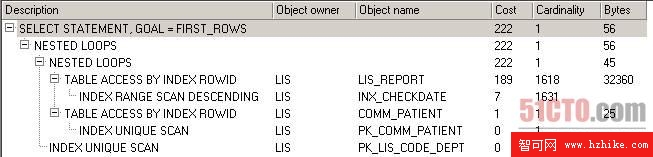
本文以實驗室信息系統(LIS)三表關聯查詢為例,演示如何通過分析執行計劃、針對 WHERE/JOIN/ORDER BY 列創建索引,逐步消除全表掃描,將查詢成本從 191 降至 189,並總結索引設計的黃金法則。
查詢 2008 年 11 月、年齡 ≥ 80 歲、姓「周」的患者檢驗記錄,按檢查日期倒序:
SELECT a.i_checkno, a.d_checkdate, b.s_name, b.s_code, b.i_age, c.s_name
FROM lis_report a
INNER JOIN comm_patient b ON a.i_patientid = b.i_patientid
INNER JOIN lis_code_dept c ON b.i_dept = c.i_id
WHERE a.d_checkdate > '2008-11-01'
  AND a.d_checkdate < '2008-11-30'
  AND b.i_age >= 80
  AND b.s_name LIKE '周%'
ORDER BY a.d_checkdate DESC;| 階段 | 操作 | 執行計劃關鍵變化 | 成本 |
|---|---|---|---|
| 0. 基線 | 無額外索引,僅主鍵索引 | lis_report 全表掃描 (191)、comm_patient 全表掃描 (18)、lis_code_dept 主鍵唯一掃描 (0) | 209 |
| 1. 給 comm_patient.i_age 建索引 | CREATE INDEX idx_pat_age ON comm_patient(i_age); | comm_patient 由全表掃描轉為索引唯一性掃描 (1),觸發主鍵索引使用 | 192 |
| 2. 給 lis_report.d_checkdate 建索引 | CREATE INDEX idx_rpt_date ON lis_report(d_checkdate); | lis_report 由全表掃描轉為索引範圍降序掃描 (189),完美匹配 WHERE 範圍 + ORDER BY DESC | 189 |
i_age 索引雖未直接出現在計劃中,但其存在改變了優化器基數估算,導致優化器選擇主鍵索引訪問路徑。| 維度 | 原則 | 理由 |
|---|---|---|
| 表大小 | 大表優先建索引 | 小表全掃更快 |
| 列使用頻率 | 高頻 WHERE/JOIN/ORDER BY 列 | 投入產出比高 |
| 數據類型 | 數值/日期 > 字符串 | 比較快、索引窄 |
| 選擇性 | 高選擇性(唯一值多)優先 | 過濾效果好 |
| 重複度 | 低重複度(如性別)慎建 | 索引掃描接近全表掃描 |
| 空值 | 允許 NULL 列慎建(B-Tree 不存全 NULL) | 查詢 NULL 需全表掃描 |
| 行數 | 極小表(< 1000 行)一般不建 | 全掃成本極低 |
| 讀寫比 | 讀多寫少表多建,寫多讀少表少建 | 索引維護開銷大 |