SELECT DISTINCT 用於回傳唯一不重複的值。當欄位包含大量重複資料(如國家、類別、狀態碼)時,DISTINCT 可快速取得不重複清單。
SELECT DISTINCT column_name, column_name
FROM table_name;
DISTINCT 必須緊接 SELECT 關鍵字。+----+--------------+---------------------------+-------+---------+ | id | name | url | alexa | country | +----+--------------+---------------------------+-------+---------+ | 1 | Google | https://www.google.cm/ | 1 | USA | | 2 | 淘寶 | https://www.taobao.com/ | 13 | CN | | 3 | 菜鳥教程 | https://www.runoob.com/ | 4689 | CN | | 4 | 微博 | https://weibo.com/ | 20 | CN | | 5 | Facebook | https://www.facebook.com/ | 3 | USA | +----+--------------+---------------------------+-------+---------+
SELECT DISTINCT country FROM Websites;
輸出結果:
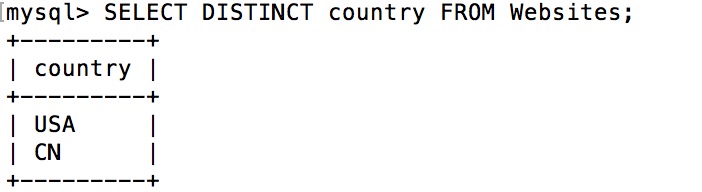
結果:CN、USA 兩個唯一值(原表有 3 筆 CN、2 筆 USA)。
SELECT DISTINCT country, alexa FROM Websites;
回傳 (CN,13)、(CN,4689)、(CN,20)、(USA,1)、(USA,3) 5 筆唯一組合。
SELECT COUNT(DISTINCT country) FROM Websites; -- 回傳 2
| 特性 | DISTINCT | GROUP BY |
|---|---|---|
| 語意 | 去重投影 | 分組彙總 |
| 可用聚合函數 | 否(僅投影) | 是 |
| 排序 | 不保證 | 通常按分組鍵排序 |
| 效能 | 較輕量 | 較重(含分組邏輯) |
單純去重用 DISTINCT;需統計、彙總用 GROUP BY。
DISTINCT 內部通常透過排序或雜湊去重,大資料量會消耗 CPU/記憶體。COUNT(DISTINCT col) 在大表上較慢,MySQL 8.0+、PostgreSQL 支援近似算法(APPROX_COUNT_DISTINCT / HYPERLOGLOG)。SELECT DISTINCT col1, col2 不是分別去重 col1、col2,而是去重 (col1, col2) 組合。DISTINCT * 等同 DISTINCT 所有欄位組合,極少使用。ORDER BY 時,排序欄位必須包含在 SELECT 清單中(部分資料庫要求)。