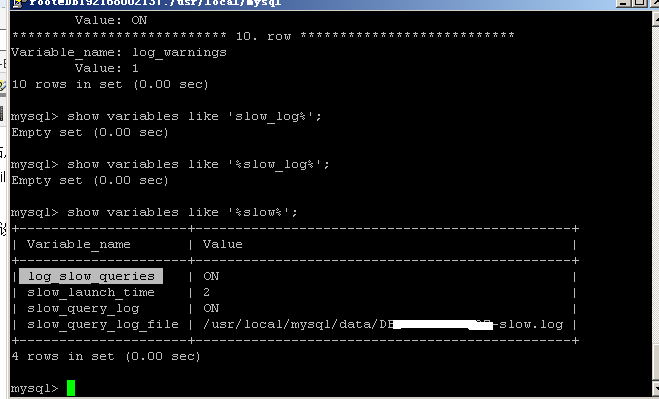
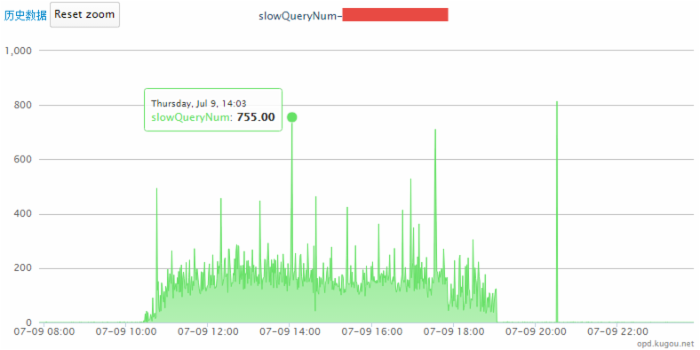
long_query_time = 3 秒,但實際執行時間達數十秒甚至 30,000 秒。# 1. 觀察慢查詢日誌分布 # 2. SHOW PROCESSLIST 發現大量積壓連線 # 3. SHOW FULL PROCESSLIST 定位頂部數條「元兇」SQL
關鍵發現:數條使用子查詢的 SQL,Time 欄位高達 30,000 秒(約 10 小時),EXPLAIN 顯示 Using temporary; Using filesort,典型的惡劣執行計畫。
# 1. 確認與開發:上午 9 點部署新代碼引入子查詢,後雖註解但連線未釋放
# 2. 批次 KILL 惡意連線
SELECT CONCAT('KILL ', id, ';')
FROM information_schema.processlist
WHERE info LIKE '%子查詢特徵%';
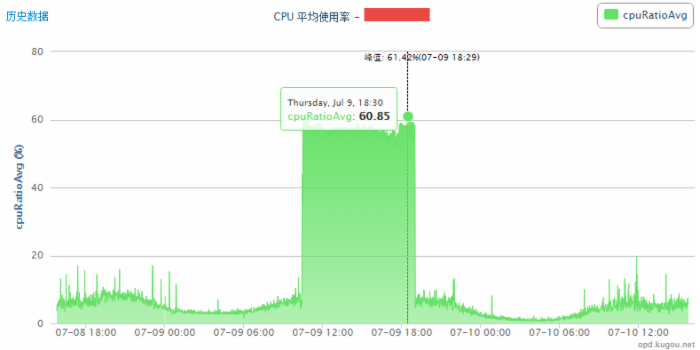
執行後連線數從 600+ 瞬間降至 100+,CPU/記憶體使用率隨即回落,服務恢復正常。
| 維度 | 分析結果 |
|---|---|
| 直接原因 | 大表子查詢產生臨時表 + filesort,單次執行極慢,佔用大量 CPU/記憶體 |
| 放大原因 | 應用端連線池未釋放舊連線,持續累積阻塞連線 |
| 觸發時間點 | 與上午代碼部署時間完全吻合 |
IN (SELECT ...) 優化較弱,優先改寫為 JOIN 或 EXISTS。SHOW PROCESSLIST → EXPLAIN → 索引/結構/代碼三層優化。# 1. 篩選目標會話 ID
mysql -uroot -p'XXX' -e "SHOW FULL PROCESSLIST;" | grep '特徵關鍵字' | awk '{print $1}' > kill_list.txt
# 2. 生成 KILL 語句並執行
mysql -uroot -p'XXX' -e "$(awk '{print \"KILL \" $1 \";\"}' kill_list.txt)"
經驗之談: 高效溝通是故障處理的加速器。DBA 應建立「每日/每週 Top N SQL 檢視機制」,主動發現潛在慢查詢,將優化前置到開發階段,而非等待故障爆發才被動救火。