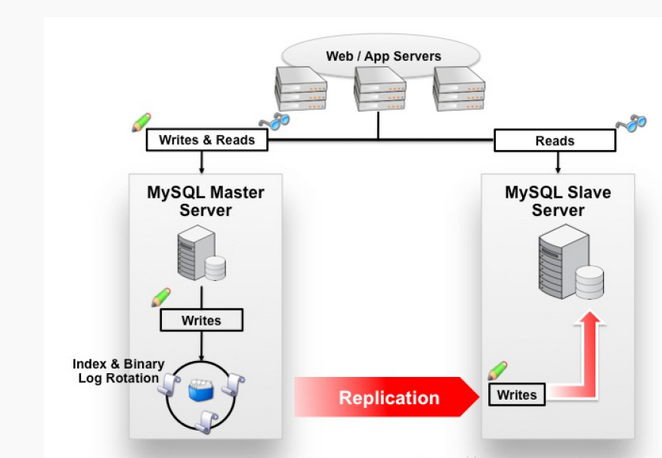
從架構圖可以清晰地看到,MySQL 異步複制下,Master 將 Binary Log 傳輸給 Slave 後,即刻向客戶端返回確認,完全不關心 Slave 是否真正接收到日志。而半同步複制則要求 Master 必須確認至少一個 Slave 已經收到並寫入 Relay Log,才會向客戶端返回提交成功。簡單對比:異步複制響應極快,但存在數據丟失風險;半同步複制犧牲少許延遲,換取主備數據強一致性保障。
線上環境默認運行異步複制,主備切換時極大概率導致備庫數據落後,需人工回滾補齊。為消除此隱患,團隊嘗試啟用半同步特性。然而詭異現象出現了:大多數實例正常運行,但少數實例始終無法啟用半同步(狀態變量 Rpl_semi_sync_master_status 持續顯示 OFF),甚至同一台物理機上的兩個實例,一個能開、一個不能。最終根因雖簡單,但排查過程卻耗費大量心力,下文將完整複現定位思路。
主備通過 Binlog 保持一致:主庫事務提交後 Binlog 落盤即返回;備庫拉取 Binlog 回放。異步模式下雙端無強同步,數據不一致在所難免。半同步機制要求每個事務至少有一個備庫確認接收,主庫纔真正提交返回。實現邏輯:主庫本地執行完畢,等待備庫回包(含最新 Binlog file/pos),收到 ACK 後通知工作線程繼續。主庫專門有一個 ack_receiver 線程負責監聽 Socket、接收 ACK 並以條件變量喚醒工作線程。
雙端均開啟半同步開關後,問題實例的 Rpl_semi_sync_master_status 始終為 OFF,說明複制實際運行在異步模式。
rpl_semi_sync_master_timeout該參數控制主庫等待 ACK 的最長時間(默認 50ms),超時則自動降級為異步。推測是網絡抖動導致 50ms 內收不到包,遂調大至 10 秒,問題依舊。
分別設置 rpl_semi_sync_master_trace_level 和 rpl_semi_sync_slave_trace_level 為 80(64+16),記錄函數進出與關鍵數據流。
【Master 日志】
2016-01-04 18:00:30 13212 [Note] ReplSemiSyncMaster::updateSyncHeader: server(-1721062019), (mysql-bin.000006, 500717950) sync(1), repl(1)
2016-01-04 18:00:40 13212 [Warning] Timeout waiting for reply of binlog (file: mysql-bin.000006, pos: 500717950), semi-sync up to file , position 0.
2016-01-04 18:00:40 13212 [Note] Semi-sync replication switched OFF.

【Slave 日志】
2016-01-04 18:00:30 38932 [Note] ---> ReplSemiSyncSlave::slaveReply enter
2016-01-04 18:00:30 38932 [Note] ReplSemiSyncSlave::slaveReply: reply (mysql-bin.000006, 500717950)
2016-01-04 18:00:30 38932 [Note] <--- ReplSemiSyncSlave::slaveReply exit (0)
關鍵發現:Slave 在 18:00:30 已發送 ACK,Master 卻等待 10 秒未收到,最終超時降級。問題轉化為:為什麼 Master 的 ack_receiver 線程收不到 Slave 發來的包?
select() 系統調用的隱形陷阱ack_receiver 線程使用 select() 監聽 Socket。select() 依賴 fd_set 位圖數組,其容量由 __FD_SETSIZE 決定(通常為 1024)。宏定義邏輯如下:
#define __FD_SETSIZE 1024
typedef long int __fd_mask;          // 8 bytes = 64 bits
#define __NFDBITS (8 * sizeof(__fd_mask))  // 64
#define __FDELT(d)  ((d) / __NFDBITS)      // 數組下標
#define __FDMASK(d) ((__fd_mask)1 << ((d) % __NFDBITS)) // 位掩碼
若文件描述符(fd)值 ≥ 1024,__FDELT(d) 將超出數組邊界,導致位圖設置溢出。select() 遍歷數組時永不檢查該位,致使高 fd 值的 Socket 永遠不可讀。代碼中完全缺乏邊界檢查,這是經典的 select() 缺陷。
ps -aux | grep mysqld | grep port 獲取 PIDgdb -p <PID> 附加info threads 找到 ack_receiver 線程並 thread <tid> 切換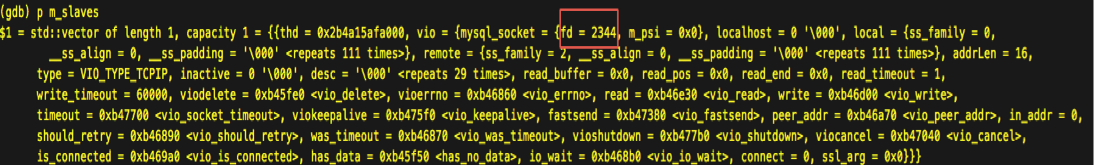
減少長連接、調小 max_connections、避免連接池洩漏,使 fd 保持在 1024 以下。
poll() / epoll()select() 為早期多路復用機制,存在 fd 上限與全量遍歷性能瓶頸。poll() 解除 fd 數量限制,epoll() 更以事件驅動實現 O(1) 就緒檢測,無最大 fd 約束。建議 MySQL 內核將半同步 ACK 接收改用 epoll()(Linux)或 kqueue(BSD/macOS)。
檢視 Oracle MySQL 5.7 源碼,半同步模塊仍沿用 select(),同樣存在此缺陷。因 fd 複用機制,低併發場景不易觸發,但高併發長連接環境下必現。
MySQL 內核存在三處 I/O 多路復用:監聽端口 select()、線程池 epoll()、半同步 select()。Slave 的 Binlog Dump 線程屬於工作線程,其 Socket 理應被線程池 epoll() 監聽,為何半同步又能單獨 select()?細查代碼發現,線程池採用 EPOLLONESHOT 模式:每次讀取後自動解綁,需重新註冊。因此同一時刻 Socket 僅被一種機制監聽,避免了衝突。
本次排查從現象切入,層層剝離:狀態異常 → 參數調整無效 → Trace 日志對比 → 內核線程分析 → 系統調用缺陷定位 → GDB 實證確認。結論雖簡單——select() 的 1024 fd 硬傷,但定位過程體現了「由上至下、由外而內」的系統級排查思維。凡涉及 select() 的場景,務必評估 fd 數量風險,優先選擇 epoll/kqueue/IOCP 等現代多路復用機制。