無索引時多表聯結需全表掃描,組合數呈指數級增長;索引讓查詢從「全掃描」變為「索引定位 + 回表」,理論提速百萬倍。
WHERE、JOIN、ORDER BY、GROUP BY 的列,而非 SELECT 輸出列。col1 = col2 的列優先。COUNT(DISTINCT col)/COUNT(*) > 0.1 適合,性別類低基數列不宜。MEDIUMINT 優於 BIGINT,VARCHAR(20) 優於 CHAR(100)。INDEX idx_name (name(10)),兼顧區分度與空間。建立 INDEX idx_a_b_c (a,b,c) 等價於擁有 (a)、(a,b)、(a,b,c) 三個索引。查詢必須從最左列開始匹配,遇到範圍查詢(>、<、LIKE '%...')停止匹配後續列。
| # | 原則 | 說明 |
|---|---|---|
| 1 | 最左前綴匹配 | a=1 AND b=2 AND c>3 AND d=4,索引 (a,b,c,d) 中 d 用不到;調整順序 (a,b,d,c) 可用到前三列 |
| 2 | = 和 IN 可亂序 | 優化器會自動重排 |
| 3 | 高區分度優先 | 區分度 > 0.1(平均 1 掃 10),JOIN 字段更應達標 |
| 4 | 索引列不參與計算 | from_unixtime(ct) = '...' 失效,改 ct = unix_timestamp('...') |
| 5 | 擴展索引不重建 | 已有 (a),需 (a,b) 直接 ALTER TABLE ... ADD INDEX (a,b) 覆蓋 |
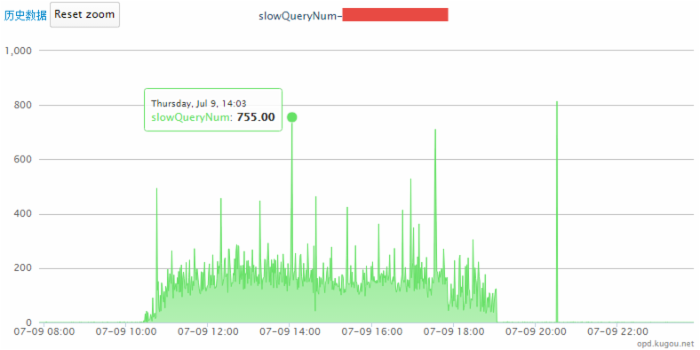
=、>、<、BETWEEN、LIKE 'prefix%',InnoDB/MyISAM 默認。=、<=>,不支援範圍;可用 USING BTREE 強制 B+Tree。開啟 slow_query_log、long_query_time,用 mysqldumpslow 分析高頻慢 SQL,針對性加索引或改寫。
索引是「查詢加速器」,但也是「寫入剎車、空間佔用者」。遵循「高區分、短類型、最左前綴、不計算、不濫建」五大原則,配合 EXPLAIN 與慢日誌持續迭代,才能實現穩健優化。