測試背景與目的
DB2 V8 XML Extender 提供兩種 XML 儲存模式:CLOB 完整儲存(未解析純文字)與 分解式儲存(映射至關聯表集合)。兩者均有已知效能瓶頸。DB2 9 引入 pureXML 技術,以原生階層格式(節點樹)儲存 XML,旨在消除上述限制。本文透過系統化基準測試,量化 pureXML 對比 CLOB 與分解式儲存的效能差異。
測試環境與資料
- 硬體:4-CPU pSeries,AIX 5.2 (64-bit),單一 DB2 9 實例
- 資料:1,000 ~ 100,000 份 CustAcc 金融文件(4KB ~ 20KB)
- 表空間:32KB 頁面、DMS、NO FILE SYSTEM CACHING(CLOB 測試除外)、分佈於 10 顆實體磁碟,日誌獨立等量區
- 統一資料庫配置與調優,確保公平對比
對比維度
| 操作 | CLOB / 分解式 | pureXML |
|---|
| 插入 | XML Extender CLOB 欄 / 新分解 (Annotated Schema Decomposition) | XML 欄位 INSERT |
| 完整文件檢索 | CLOB 直接讀取 | XML 序列化後讀取 |
| 查詢/擷取 | CLOB:查詢時解析 (Extract UDF) / 分解式:SQL/XML Publishing | XQuery 原生查詢 |
核心發現
1. 插入效能
- 單用戶循序插入 (Commit 每筆):CLOB 最快(基準 100%),pureXML 慢約 5~10%(含 6 個 XML 索引僅增 5% 開銷)。
並發插入:典型 OLTP 負載下,CLOB 因鎖爭用反而比 pureXML 慢 2~2.5 倍。
- pureXML vs 新分解:每筆 Commit 下 pureXML 快 60~70%;批次插入 (Commit 每 50/100 筆) pureXML 快 4~5 倍(受惠於更大的群組 Commit 效益)。
註:新分解速度已是 V8 XML Extender 分解的 7~8 倍。
2. 查詢效能 (無索引、無檔案系統快取)
5 個代表性查詢 (Q1~Q5):全表掃描、單一謂詞單一文件、多謂詞多文件、部分欄位全表、部分欄位帶謂詞。
pureXML XQuery 速度達 CLOB Extract 查詢的 20~40 倍。主因:CLOB 每次查詢必須解析 XML,CPU 開銷極大;pureXML 插入時已解析,查詢直接走節點樹。
檔案系統快取影響:僅 Q1 (全表完整檢索) 受惠顯著。啟用快取後 CLOB Q1 速度超過 pureXML 2 倍以上(因 pureXML 需序列化)。但實務上 XML 欄位在緩衝池快取,CLOB 不在,綜合負載下 pureXML 優勢更明顯。
3. 索引效能對比
- CLOB 依賴 Side Table (索引表):插入時擷取特定元素/屬性至關聯表,查詢時 Join 主表。插入開銷大,多謂詞需多路 Join (Q3 用 3 個 Side Table + 主表 = 4-way Join)。
- pureXML 原生 XML 索引:直接指向文件節點,無需 Join。
有索引下 pureXML 比 CLOB Side Table 快 6~35 倍。Q5 仍需 Extract 函數解析,拖累 CLOB 效能。
4. pureXML vs 分解式 + SQL/XML Publishing
- 相對效能取決於 需重建的 XML 結構複雜度 與 Join 數量。
- 複雜文件重建:XQuery 快 50~100 倍(避免大量 Join 與 XML 產生)。
- 簡單查詢、少量標籤:SQL 可能更快。
- 應用需在插入/查詢效能間權衡,評估混合負載特性。
效能總結圖表
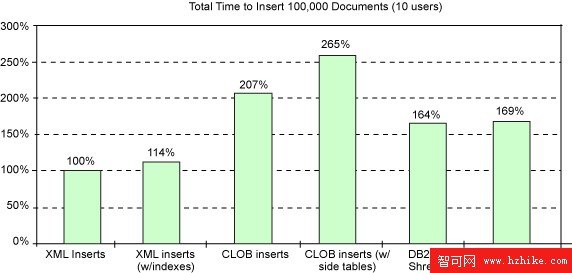
圖示關鍵訊息:並發 OLTP 負載下 pureXML 插入效能超越 CLOB;批次載入 pureXML 大幅領先新分解;查詢端 pureXML 壓倒性優勢。
結論與建議
- 純查詢/分析負載:pureXML 為最佳選擇,查詢效能數量級領先。
- 高併發 OLTP 混合負載:pureXML 綜合效能最優(插入可接受、查詢極快、鎖爭用低)。
- 大量批次載入 + 少量查詢:新分解或 CLOB 可考慮,但 pureXML 批次模式同樣具備 4~5 倍優勢。
- 遺留系統相容:需餵關聯式 BI/報表工具時,可搭配新分解產生關聯視圖,pureXML 為主儲存。
pureXML 以「寫時解析、讀時直達」架構重新定義 XML 資料庫效能基準,是 DB2 9 最具革命性的技術突破之一。