XML 的內在價值:自描述、跨系統互通
- 靈活標記:自定義 Tag 定義資料型別、屬性、階層
- 自解釋:無需外部數據字典,異構系統間直接交換
- 標準化:W3C 標準,各語言成熟解析器生態
關聯模型的痛點:阻抗失配與效能稅
- 剖析/映射/重組:XML → 關聯表拆解 → 入庫 → 查詢時再 JOIN 重組
- 資料膨脹:稀疏屬性導致大量 NULL 欄位或 EAV 模式效能低落
- 結構變更痛苦:Schema 演進需 DDL 修改表結構、遷移資料、重建索引
- 查詢表達受限:XPath/XQuery 豐富語義難以在純 SQL 中自然表達
DB2 9 pureXML 的破局創新
| 維度 | 傳統關聯模擬 XML | DB2 9 pureXML |
|---|
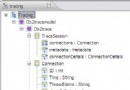
| 儲存格式 | 關聯表 (CLOB/BLOB/拆解) | **原生階層樹狀結構** (專屬 XML 型別) |
| 索引 | 關聯索引/全文索引 | **XML 索引** (路徑/值/全文),支援 XPath 直接定位 |
| 查詢語言 | SQL + UDF 處理 XML | **SQL/XML + XQuery** 無縫混合,單一陳述式完成關聯+XML 聯合查詢 |
| Schema 驗證 | 應用層/觸發器 | **資料庫內建驗證** (XML Schema Repository, XMLVALIDATE) |
| 結構演進 | DDL 修表、遷移數據 | **無 Schema 綁定** 或多 Schema 共存,單欄位存異構文件 |
| 效能 | 多次 I/O、CPU 密集轉換 | **原生處理**,避免序列化/反序列化,向量化 XML 處理引擎 |
DB2 9 綜合優勢與已知限制
優勢
- 資料倉庫/BI:星型查詢優化器成熟、MQT/MDC/表分區組合拳、DPF 線性擴展
- 優化器:複雜查詢重寫能力強、自適應連接/並行度、成本模型精準
- 企業級特性:HADR、TASMP、LBAC、資料壓縮、備份壓縮/加密
限制與注意點
- 鎖機制敏感:記憶體鎖高效但對優化要求高;應用/索引/統計資訊不足易發生鎖等待/升級
- API/函數庫:相比 Oracle/PostgreSQL,內建函數、擴展介面較少(Toronto 實驗室持續增強中)
- 高可用配置複雜:HADR/TASMP 參數多、故障切換邏輯繁瑣,需深度閱讀 IBM 紅皮書
- DPF 運維門檻:分區鍵選擇、資料傾斜監控、跨分區連接並置、重分佈操作需資深 DBA
架構演進建議:擁抱「關係+XML」混合模型
- 核心業務實體:關聯表(ACID、強一致、成熟工具鏈)
- 半結構化/變動結構:XML 欄位(產品屬性、日誌、文檔、Web 服務酬載)
- 查詢層:SQL/XML 發布函數 (
XMLQUERY, XMLELEMENT, XMLAGG) 直接產出 XML/JSON 服務
- 索引策略:關聯欄位建 B-tree;XML 路徑建 XML 索引;全文建 Text 索引
總結
DB2 9 **pureXML 不是功能附加,而是儲存引擎層面的原生支援**。它消除了「關聯與 XML 二選一」的假兩難,讓企業在單一資料庫平台上同時擁有關聯模型的嚴謹一致性與 XML 模型的靈活擴展性。對於面臨「多來源異構資料整合、快速 Schema 演進、Web 服務原生發布」挑戰的組織,DB2 9 是極具戰略價值的選擇。關鍵在於:**深入理解混合模型設計模式、投入 XML 索引規劃、建立統計資訊維護機制**,將 pureXML 從「可用」變為「好用、穩用」。