邏輯資料建模深度解析
資料表正規化與反正規化
正規化是將實體拆分為多個物理資料表的過程,屬邏輯建模應用。核心目標:消除冗余資料、確保有效資料相依性、最大化系統彈性以因應未來結構增長。
第三正規形式 (3NF) 規則精要
- 消除重複群組:每組相關屬性建立獨立資料表並指定主鍵
- 消除同表重複欄位
- 每組相關資料建立獨立資料表,以唯一鍵識別每列
- 消除冗余:僅依賴複合鍵部分的屬性移至獨立資料表
- 移除套用至多列的資料至獨立資料表
- 透過外鍵建立有效資料表關聯
- 刪除不依賴主鍵的欄位
邏輯模型應維持 3NF,提供隨業務演進的彈性模型。雖然 3NF 部署時常效能不彰,但它是靈活設計的基石。
正規化實戰範例
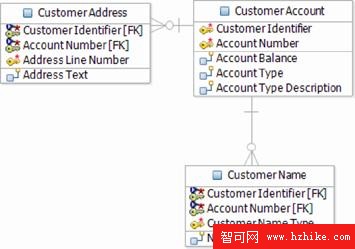
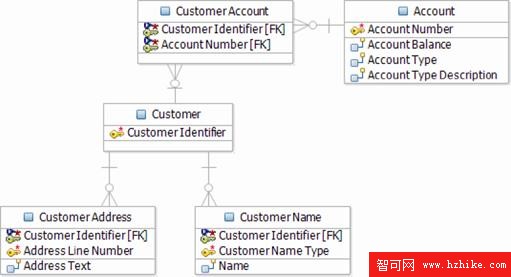
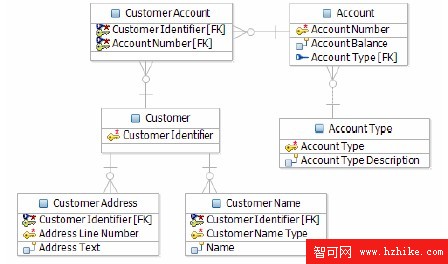
以反正規化模型為起點,逐步遵循 1NF、2NF、3NF:
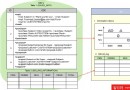
- 1NF:移除重複群組(如 Address Line 1-3、Customer First/Last Name),建立新實體並定義主鍵/外鍵。姓名正規化可預留中間名、前後綴擴充空間。
- 2NF:在 1NF 基礎上,移除部分相依於複合鍵的屬性(如 City/State/Zip Code 模式固定,獨立為 Zip Code 實體)。
- 3NF:在 2NF 基礎上,移除遞移相依屬性(非鍵屬性由另一非鍵屬性決定),建立新實體並維護關聯。
反正規化策略
屬物理建模應用,將資料表合併以提升效能、降低管理複雜度。星型/雪花模式常用於資料倉庫(BI 系統):
- 星型模式:中央事實表(時變事件)環繞維度表(屬性如位置、客戶、部件)
- 雪花模式:將低基數欄位從維度表再拆分至次維度表
反正規化會增加冗余、降低靈活性,不建議用於邏輯模型,應作為物理建模滿足效能/管理需求的手段。
邏輯資料模型正規化最佳實踐
- 始終遵循 3NF
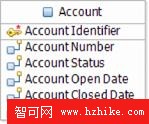
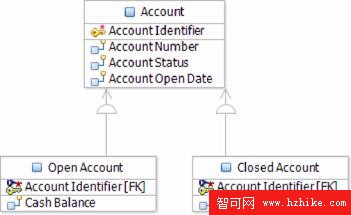
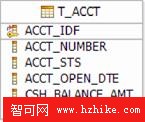
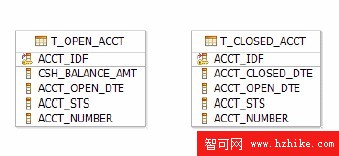
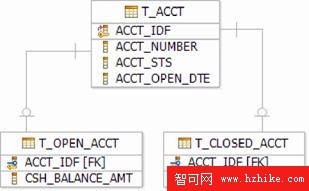
- 善用 一般化關聯(超型/子型):如「帳戶」為父實體,「開啟帳戶/關閉帳戶」為子型,各擁有獨特屬性,父實體保留共通屬性。此關聯不僅豐富語意,物理轉換時可選擇向上合併、向下推送或保持獨立三種策略。
團隊共享協作機制
模型若無法在相關社群廣泛應用,組織價值有限。RDA 提供強大團隊共享功能:
- 套件分離邏輯實體:降低大型模型複雜度,利於理解
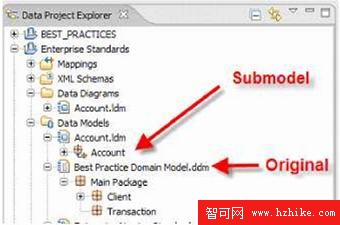
- 從套件建立子模型:將大模型拆解為小模型,僅簽出/簽入需變更的子模型,大幅減少合併衝突與耗時。若兩人分處不同子模型,可同時簽入互不干擾;衝突發生時合併較小範圍更高效。
建立子模型步驟
- Data Project Explorer 右鍵現有套件
- 選擇 Create Submodel from package
物理資料建模實戰
創建特定資料庫模型以滿足應用效能需求。規劃資料庫增長極具挑戰,尤其 BI 環境初始部署成功後常持續擴充資料源。
正規化與反正規化物理策略
- OLTP/通用資料庫:採 3NF 維持設計彈性
- 資料倉庫/資料集市:星型/雪花模式適合維度查詢,但需驗證符合邏輯模型設計關聯
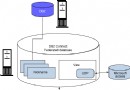
- 多用途廣泛數倉(ODS、報表、OLAP、Cube):採 IBM 分層資料架構
- 極窄資料表(每列 ≤ 30 bytes):考慮反正規化,減少資料表數量降低查詢/管理複雜度
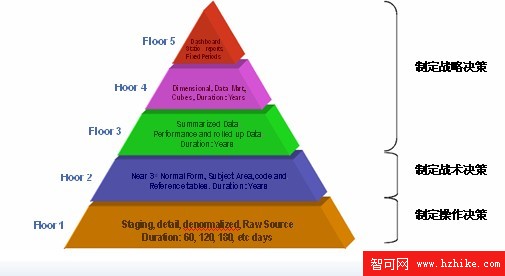
架構五層(自上而下):儀表板靜態報表(固定期限)→ 維度/資料集市/多維資料集(年)→ 摘要資料/效能上卷資料(年)→ 接近 3NF/主題區/代碼參考表(年)→ 整理/明細/反正規化/原始來源(60/120/180 天)
索引設計最佳實踐
索引提供快速查找,對效能至關重要,但也增加 UPDATE/INSERT/DELETE/LOAD 成本、編譯成本與儲存空間。
- 所有主鍵與大多數外鍵建立索引(多數連接發生於 PK-FK)
- SQL WHERE 子句頻繁引用屬性考慮建索引(不等式謂詞如
WHERE cost <> 4 除外)
- 等值與範圍查詢有效利用索引