傳統遞歸快速排序在資料量極大(如 800 萬)時極易導致 StackOverflowError。雖然可透過 -Xss 增加棧大小,但治標不治本。本文採用顯式二叉樹模擬遞歸棧,將遞歸轉為迭代,徹底解決棧溢出問題,且保持 O(N log N) 平均時間複雜度。
[left, right]。[0, n-1]。left 索引元素為基準,雙指針交換,使基準左邊全大於基準,右邊全小於基準(降序),基準最終位置為 mid。[left, mid-1] 為左子節點,右子區間 [mid+1, right] 為右子節點。class Binary {
private int left, right; // 區間邊界
private Binary beforeBinary; // 父節點
private Binary leftBinary; // 左子節點(左區間)
private Binary rightBinary; // 右子節點(右區間)
// getter/setter 省略
}
public static void quick_sort(int[] arr) {
    Binary root = new Binary(0, arr.length - 1);
    root.setBefore(null);
    Binary curr = root;

    do {
        // 1. 分區
        int l = curr.getLeft();
        int r = curr.getRight();
        int pivot = arr[l];
        while (l < r) {
            while (l < r && pivot >= arr[r]) r--;
            if (l < r) arr[l++] = arr[r];
            while (l < r && pivot <= arr[l]) l++;
            if (l < r) arr[r--] = arr[l];
        }
        arr[l] = pivot; // l == r == mid

        // 2. 建立子節點
        if (r < curr.getRight() - 1) {
            Binary rightChild = new Binary(r + 1, curr.getRight());
            curr.setRightBinary(rightChild);
            rightChild.setBefore(curr);
        }
        if (l - 1 > curr.getLeft()) {
            Binary leftChild = new Binary(curr.getLeft(), l - 1);
            curr.setLeftBinary(leftChild);
            leftChild.setBefore(curr);
        }

        // 3. 遍歷策略:優先左子樹,左無則右,右也無則回父節點
        boolean moved = false;
        do {
            if (curr.getLeftBinary() != null) {
                Binary next = curr.getLeftBinary();
                curr.setLeftBinary(null); // 關鍵:斷開引用,允許 GC
                curr = next;
                moved = true;
            } else if (curr.getRightBinary() != null) {
                Binary next = curr.getRightBinary();
                curr.setRightBinary(null);
                curr = next;
                moved = true;
            } else {
                if (curr == root) break; // 回到根節點,結束
                curr = curr.getBeforeBinary(); // 回父節點
            }
        } while (!moved);
    } while (curr != root);
}
| 資料量 | 耗時 | 記憶體 |
|---|---|---|
| 800,000 | ~1 秒 | 正常 |
| 8,000,000 | ~66 秒 | 正常 |
| 80,000,000 | — | Heap OOM(陣列本身超過堆上限) |
| 優點 | 缺點 |
|---|---|
| 無棧溢出風險,支援極大資料量 | 額外二叉樹節點物件開銷(~幾十 MB) |
| 可中斷、可視化、易於並行化改造 | 最壞情況 O(N²)(可引入隨機基準或三數取中優化) |
| 原地排序,空間複雜度 O(log N) 節點 + O(N) 陣列 | 非穩定排序 |
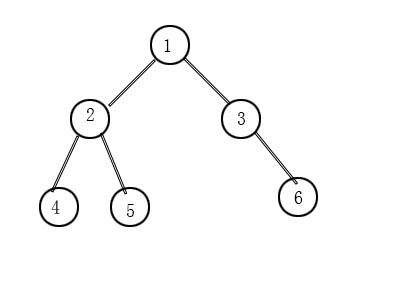
ForkJoinPool 併行處理左右子樹。