前言
Java 效能問題 80% 源於代碼本身而非語言特性。養成優良編碼習慣是提升效能最直接、成本最低的途徑。本文彙總 31 條實戰優化技巧,涵蓋對象管理、集合選擇、並發控制、IO 操作、JVM 層面等核心領域。
對象與內存管理
1. 善用 final 修飾符
- final 類不可繼承(如 String),方法隱式 final
- 編譯器可內聯 final 方法,平均提效 50%+
- final 變量編譯期常量折疊,運行期不可變
2. 重用對象,避免過度創建
- 字符串拼接用
StringBuilder/StringBuffer 替代 +
- 頻繁創建/銷毀對象增加 GC 壓力,導致停頓
- 對象池模式適用於昂貴對象(線程、連接、大緩衝區)
3. 優先使用局部變量
- 棧分配:方法參數、局部變量 → 速度快、自動回收
- 堆分配:實例變量、靜態變量 → 需 GC、較慢
- 能用局部變量解決的,不用成員變量
4. 避免重複初始化
- 構造鏈自動初始化:new 觸發所有父類構造器
- 複雜初始化移至
initXXX() 方法,避免空指針
- 延遲初始化:需要時才創建
5. 及時釋放資源引用
- 大對象用畢手動置 null:
bigObj = null;
- 集合清空:
list.clear(); list = null;
- try-with-resources 確保流/連接關閉
6. 克隆替代 new 創建實例
// 工廠模式優化
private static Prototype base = new Prototype();
public static Prototype create() { return (Prototype) base.clone(); }
// clone() 不調用構造器,避免構造鏈開銷
集合與數據結構選擇
7. 減少重複計算
// 差
for (int i = 0; i < list.size(); i++) {}
// 優
for (int i = 0, len = list.size(); i < len; i++) {}
8. StringBuilder 預設容量
- 默認 16 字符,擴容 2n+2 伴隨數組複製
- 預估大小:
new StringBuilder(estimatedSize)
9. Vector/ArrayList 擴容機制
- Vector:默認 10,擴容 2倍;同步開銷大
- ArrayList:默認 10,擴容 1.5倍;非同步
add(index, obj) 觸發後續元素位移,尾部插入最快- 刪除優先
removeAllElements() 或尾部刪除
10. 大量數據複製用 System.arraycopy()
- native 實現,比手工循環快數倍
- Arrays.copyOf() 內部同樣調用它
11. 數組 vs ArrayList
- 數組:效能最高、容量固定、類型安全
- ArrayList:動態擴容、豐富 API、輕微開銷
- 高頻讀寫、固定大小 → 數組
12. 單線程優先 HashMap/ArrayList
- Hashtable/Vector 同步開銷大,已過時
- 多線程用 ConcurrentHashMap/CopyOnWriteArrayList
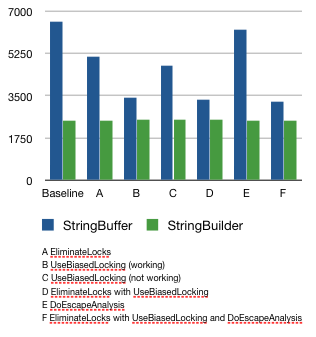
13. StringBuilder vs StringBuffer
- StringBuilder:非同步、JDK 5+ 推薦、快 10-15%
- StringBuffer:同步、線程安全
- 綜合建議:單線程 StringBuilder,多線程 StringBuffer
14. 基本類型優於包裝類型
int vs Integer:避免裝箱/拆箱、減少對象頭開銷- 集合存基本類型考慮專用庫(Trove, FastUtil)或基本類型數組
演算法與邏輯優化
15. 位運算替代乘除
i * 2  -> i << 1
i / 2  -> i >> 1
i % 2  -> i & 1
// 加註釋說明業務含義
16. 查表法替代複雜計算
- 三角函數、對數、平方根等預計算查表
- 空間換時間,嵌入式/遊戲開發常用
17. 異常僅用於異常流程
- 創建異常對象、填充堆疊追蹤開銷極大
- 嚴禁用異常控制業務流程(如循環終止)
- 循環外包 try-catch,非循環內
18. 具體類優於介面引用(微優化)
- 直接調用具體類方法避免虛表查找
- 現代 IDE/JIT 已優化,影響微乎其微
- 靈活性優先,效能次之
JVM 與進階調優
19. 靜態方法優於實例方法
- 無需 this 參考、虛表分派,調用稍快
- 語義明確:不修改對象狀態
20. 避免內部 Getter/Setter(Android/高頻場景)
- 虛方法調用開銷 > 字段直接訪問
- 類內部直接訪問字段,外部才用 Getter/Setter
21. 謹慎使用枚舉/浮點數
- 枚舉實質是類,有初始化開銷
- 浮點運算比整數慢,定點數替代金融計算
22. 二維數組內存開銷大
- Java 二維數組 = 數組的數組,對象頭開銷 ~10倍一維
- 大矩陣用一維數組
index = row * cols + col
23. SQLite 條件查詢較慢
- 全表掃描快,帶 WHERE 條件 30-50ms
- 避免嵌套子查詢,建立索引,考慮 Room/GreenDAO
代碼質量與重構
24. 代碼重構提升可讀性
- 可讀代碼易於優化、維護、並行化
- 提取方法、引入解釋變量、移除重複
25. 合理使用設計模式
- 單例、工廠、策略、觀察者等減耦合
- 過度設計反而增加開銷
總結:優化優先級金字塔
- 架構/演算法層:O(n²)→O(n log n)、緩存策略、異步化
- 數據結構層:正確集合選擇、索引設計
- 代碼習慣層:本文 31 條技巧
- JVM 參數層:堆大小、GC 算法、JIT 編譯
- 硬體/OS 層:CPU、內存、網路、磁盤
**原則**:測量優先(JMH、Profiler),瓶頸導向,過早優化是萬惡之源。