在上一篇文章中,我們介紹了如何編寫 Spider 程式爬取網頁,獲得按特定格式儲存的原始網頁庫。本文將深入探討搜尋引擎核心環節——網頁預處理,將原始網頁轉化為可高效檢索的資料結構。
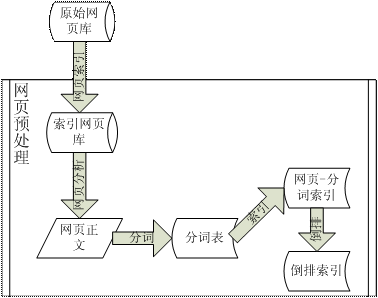
預處理模組包含四大核心步驟:建立索引網頁庫、正文資訊抽取、中文分詞、建立正向與倒排索引。原始網頁雖有良好儲存格式,但無法直接透過 URL 定位。因此首要任務是建立索引,將 URL 對應到原始庫中的具體位置(檔案名+偏移量),並儲存網頁內容的 MD5 摘要作為校驗碼,確保後續讀取資料的完整性。
採用 MySQL 資料庫儲存索引資訊,表結構包含 url、content(MD5摘要)、offset(偏移量)、raws(庫名)。讀取原始庫時,透過記錄間的空行分隔頭部與資料區,計算記錄長度以推導下一條記錄的偏移值。偽代碼邏輯如下:
For each record in Raws do
 begin
  讀取 record 的頭部和數據,從頭部中抽取 URL;
  計算頭部和數據的長度,加到當前偏移值上得到新的偏移;
  從 record 中數據中計算其 MD5 摘要值;
  將數據插入數據庫中,包括:URL、偏移、數據 MD5 摘要、Raws;
 end;
MD5 演算法產生 128 位雜湊值(32 位十六進制字串),任何資料異動都會導致摘要改變,堪稱資料的「指紋」。
OriginalPageGetter 類別負責從原始庫讀取網頁內容:根據 URL 查詢資料庫獲得庫名與偏移,使用 BufferedReader.skip(offset) 定位,讀取內容並驗證 MD5。正文抽取採用正則表達式移除 HTML 標籤(如 <script>、<style> 等),保留純文字內容供分詞使用。
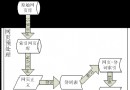
採用「正向最大匹配法」(MM):從句子開頭取最長字串匹配詞典,失敗則減字重試,直到匹配成功或剩單字。流程如下:
分詞後需過濾停用詞(如「的、了、和」),分詞字典可從開源專案獲取,停用詞表則可自行整理。分詞品質直接決定搜尋精準度,生產環境常結合雙向匹配、詞頻統計優化歧義處理。
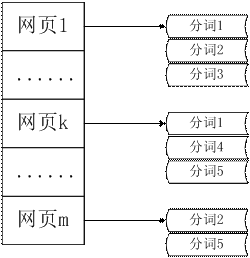
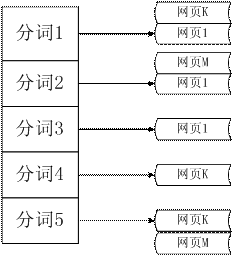
正向索引:URL → 分詞列表。倒排索引:分詞 → 包含該詞的 URL 列表。建立演算法:遍歷每個網頁的分詞列表,若詞條不存在於倒排表則新增並記錄 URL,否則追加 URL。dySE 使用 HashMap 儲存,鍵分別為 URL 與詞條,值為對應列表。優化方向可將列表改為整數 ID 節省空間。
建立倒排索引後,即可在程式中直接測試:輸入關鍵字,查找倒排表返回 URL 列表。網頁預處理是搜尋引擎的核心,索引庫解決定位問題,正文抽取奠定基礎,分詞品質決定精準度,倒排索引則是檢索速度的關鍵資料結構。下一部分將介紹查詢服務、結果排序與快照功能。