想親手打造一個搜尋引擎嗎?輸入關鍵字、點擊搜尋、獲得精準結果——這不僅酷炫,更能應用於站內搜尋、檔案檢索等場景。本系列三篇文章將完整呈現 dySE 搜尋引擎的設計與實作,首篇聚焦網路爬蟲模組。
Java 提供豐富的網路程式基礎類(URL、InetAddress、正則表達式等),讓開發者專注於搜尋引擎核心邏輯,而非底層通訊細節。
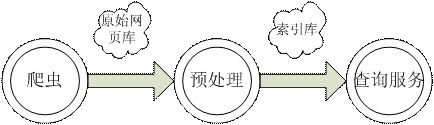
dySE 採用經典三階段架構,各模組獨立運作,透過資料流串聯:
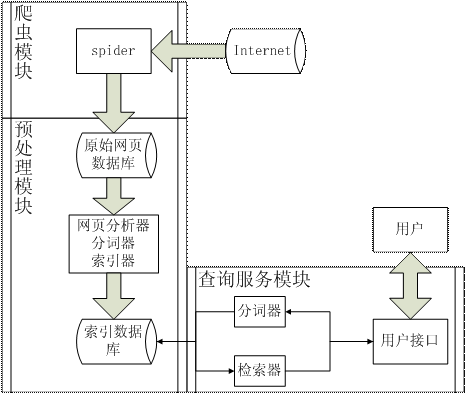
從用戶查詢角度自頂向下看:查詢詞經分詞切割、去除停用詞,透過倒排索引找到包含所有詞條的網頁集,再計算相關度(PageRank)排序。倒排索引源於正向索引(網頁→詞條)的轉置,正向索引又基於網頁分析器抽取正文後的分詞結果。原始網頁由爬蟲收集儲存本地。
網頁收集等同於有向圖遍歷:網頁為節點,超連結為邊。採用廣度優先策略(BFS),流程如下:
URLConnection 建立連線,BufferedReader 讀取資料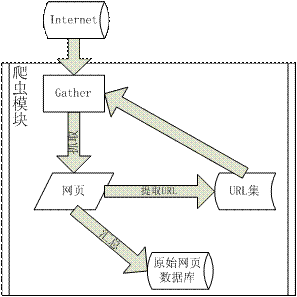
URL url = new URL("https://www.xxx.com");
URLConnection conn = url.openConnection();
BufferedReader reader = new BufferedReader(new InputStreamReader(conn.getInputStream()));
String line = null;
while((line = reader.readLine()) != null)
    document.append(line + "\n");
兩步驟完成:
<[a|A]\s+href=([^>]*\s*>) 匹配完整 <a> 標籤,再截取雙引號間的 URL維護「已訪問表」與「未訪問表」,避免重複爬取。多執行緒環境下,synchronized 關鍵字保證線程安全存取。
public void start() {
    Dispatcher disp = Dispatcher.getInstance();
    for(int i = 0; i < gatherNum; i++){
        Thread gather = new Thread(new Gather(disp));
        gather.start();
    }
}
Spider 為搜尋引擎奠定資料基礎,其設計涵蓋網路通訊、資料儲存格式、URL 管理、多執行緒併發控制等核心課題。稍加修改即可應用於特定資訊收集(如圖片爬蟲)。下一部分將詳細講解預處理模組如何將原始網頁轉化為可檢索的索引結構。