在大型 Web 應用中,分布式緩存集群擴容時,傳統 hash(key) % N 取模路由會導致大量緩存失效,引發緩存雪崩風險。一致性哈希通過將機器節點與數據鍵映射到同一哈希環,僅影響順時針方向上首個節點的數據,將遷移量降至理論最小。本文深度解析算法原理、虛擬節點優化、Java 實現要點及生產環境注意事項。
0 ~ 2^32-1(32 位無符號整數),首尾相接形成環。hash(key),順時針尋找首個節點,即為目標存儲節點;若超過 2^32 未找到,回環命中第一個節點。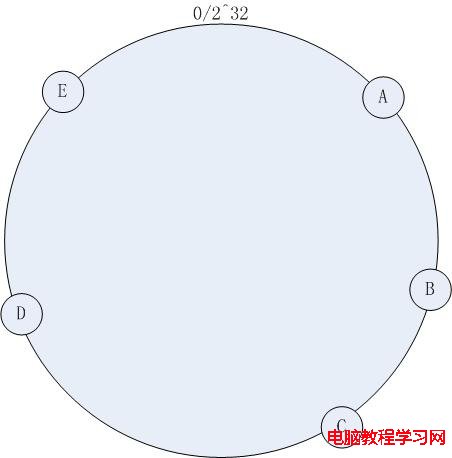
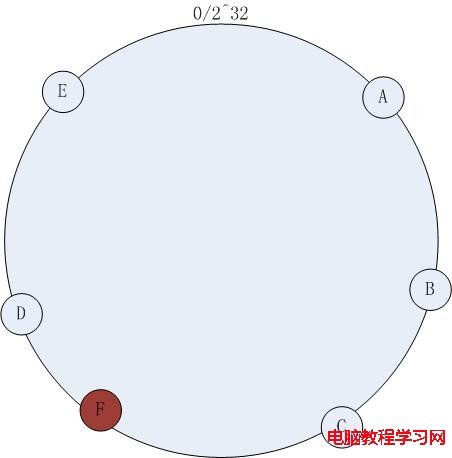
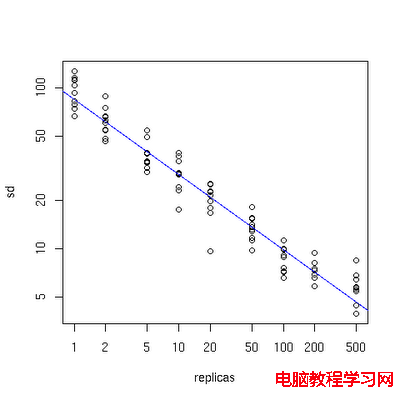
物理節點較少時,哈希值分布不均會導致負載嚴重傾斜。虛擬節點技術為每個物理節點在環上創建多個副本(通常 100~200 個),鍵映射到虛擬節點後再透過映射表定位物理節點。
import java.util.*;
import java.security.MessageDigest;

public class ConsistentHash<T> {
    private final int virtualNodes;
    private final SortedMap<Long, T> ring = new TreeMap<>();
    private final Map<T, List<Long>> nodeVirtualMap = new HashMap<>();

    public ConsistentHash(int virtualNodes, Collection<T> nodes) {
        this.virtualNodes = virtualNodes;
        for (T node : nodes) addNode(node);
    }

    // FNV-1a 32位哈希,性能優於 MD5
    private long hash(String key) {
        long h = 0x811c9dc5L;
        for (byte b : key.getBytes(StandardCharsets.UTF_8)) {
            h ^= b & 0xFF;
            h *= 0x1000193L;
        }
        return h & 0xFFFFFFFFL;  // 32位無符號
    }

    public void addNode(T node) {
        List<Long> virtuals = new ArrayList<>(virtualNodes);
        for (int i = 0; i < virtualNodes; i++) {
            long h = hash(node.toString() + "#VN" + i);
            ring.put(h, node);
            virtuals.add(h);
        }
        nodeVirtualMap.put(node, virtuals);
    }

    public void removeNode(T node) {
        for (Long h : nodeVirtualMap.remove(node)) ring.remove(h);
    }

    public T getNode(String key) {
        if (ring.isEmpty()) return null;
        long h = hash(key);
        SortedMap<Long, T> tail = ring.tailMap(h);
        return (tail.isEmpty() ? ring.firstEntry() : tail.firstEntry()).getValue();
    }
}
| 維度 | 建議 |
|---|---|
| 哈希函數 | 優先 FNV-1a、MurmurHash3、CRC32;避免 MD5/SHA(性能差) |
| 節點標識 | 使用穩定唯一 ID(如 UUID),避免 IP 變更導致節點身份改變 |
| 客戶端感知 | 客戶端緩存環狀態,定期從配置中心(ZooKeeper/Etcd/Nacos)拉取更新 |
| 熱點鍵 | 極熱鍵單獨處理:本地緩存 + 隨機過期 + 熔斷降級 |
| 監控指標 | 節點負載方差、命中率、遷移數據量、環狀態版本號 |
一致性哈希是分布式系統中「最小化變更影響」的經典實踐。理解其數學本質、工程權衡與生態落地,能幫助你在緩存、服務發現、分片路由等場景做出穩健的架構決策。