垃圾回收演算法可從不同維度劃分,本文依基本回收策略、分區對待方式、系統線程模型三大面向系統整理。
較古老演算法。原理:物件被引用計數+1,引用刪除計數-1。GC 時收集計數為 0 的物件。致命缺陷:無法處理循環引用 (A→B、B→A 計數永不歸零)。
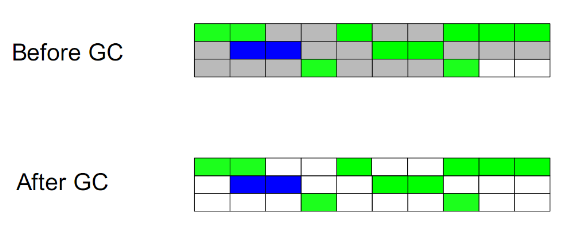
兩階段:
缺點:需暫停整個應用 (Stop-the-World);產生記憶體碎片,不利大物件分配。
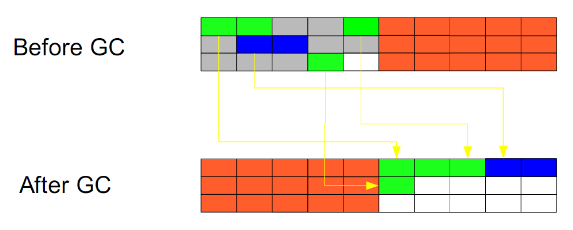
將記憶體劃為兩塊等大區域 (From/To),每次僅使用一塊。GC 時將 From 區存活物件複製到 To 區,然後交換角色。
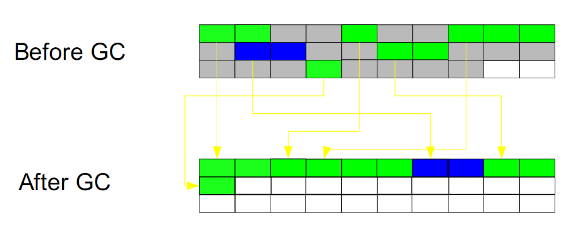
結合上述兩演算法優點:
優點:避免標記-清除的碎片問題,亦避免複製演算法的空間浪費。
代價:整理階段需移動物件、更新引用,開銷較大。
即時 GC 演算法:應用運行同時進行垃圾回收。JDK 5.0 收集器未採用 (原因不明)。
基於物件生命週期分析:將堆劃分為新生代、老年代、永久代 (JDK 8+ 為 Metaspace),對不同代使用不同演算法。
現狀:J2SE 1.2 起所有商用收集器皆採用此演算法。
| 類型 | 特點 | 優點 | 缺點/適用場景 |
|---|---|---|---|
| 串行收集 | 單執行緒處理所有 GC 工作 | 無多執行緒交互開銷,實現簡單,單執行緒效率高 | 無法利用多處理器優勢,適合單處理器或小資料量 (~100MB) 多處理器環境 |
| 並行收集 | 多執行緒並行處理 GC 工作 | 速度快、效率高;CPU 核心數越多優勢越明顯 | 仍需 Stop-the-World,暫停時間隨堆增大而增長 |
| 並發收集 | GC 執行緒與應用執行緒同時運行 | 大幅減少應用暫停時間,適合低延遲需求系統 | 實現複雜,需處理浮動垃圾、並發模式失敗等問題;CPU 開銷較大 |
關鍵差異:串行/並行收集執行 GC 時必須暫停整個運行環境 (Stop-the-World),唯有 GC 執行緒運行;並發收集則允許應用與 GC 同時進行。
理解演算法特性是 JVM 調優的理論基石,實際調優需結合具體收集器實作 (Serial、Parallel、CMS、G1、ZGC 等) 參數配置。