關於記憶體模型,這是個被「說爛」了的話題。五六年前初接觸 .NET 時,各路大牛便開始探討。當時懷著崇敬之心閱讀那些文字與思想,每次重讀都收穫頗豐。但大牛們言簡意賅,儘管讀過多次,仍常因時間流逝與記憶衰退而遺忘。近期下定決心撰寫此文,匯總諸家思想、聚集近年結論,加上微薄心得,力求準確翔實、圖文並茂。程序員互助,是為題記。
身為程序員,您想過沒有:若 CPU 不按程序編寫順序執行,結果會如何?若您未曾意識到這點,可能會震驚。但在多核多處理器時代,這正是事實:CPU 會調整指令執行順序,以調整後的順序執行,這是提高 CPU 效率的關鍵措施。
除了極少數 .NET 框架設計者早年遭遇此問題,撇開 C++/Java 程序員,許多 .NET 開發者首次意識到這問題,往往是在雙重檢查鎖定 單例模式 實現時。
public class Singleton {
    private static object syncRoot = new object();
    private Singleton instance;
    private Singleton() { }
    public Singleton Instance {
        get {
            if (instance == null) {
                lock (syncRoot) {
                    if (instance == null) {
                        instance = new Singleton();
                    }
                }
            }
            return instance;
        }
    }
}
此實現有瑕疵。多核 CPU 上,兩核心同時執行 Instance 代碼。Processor 0 執行到釋放鎖時,因 CPU 快取與寫緩衝區存在,主記憶體中 Singleton 物件可能尚未創建。Processor 1 判斷 instance == null 仍為真,進而創建另一個 Singleton 物件!最終得到兩個完全無關的單例物件。
public class Singleton {
    private static object syncRoot = new object();
    private volatile Singleton instance;
    // ... 餘下相同
}
僅在私有實例前加 volatile。MSDN 解釋:volatile 指示欄位可能被多線程同時修改,編譯器不會優化為單線程訪問,確保欄位值始終最新。但真相果真如此?加了 volatile 單例就完美了?有更好實現嗎?探究根源,須從現代 CPU 結構談起。
現代 CPU 架構主要有 x86、AMD64 (x64)、IA-64 三類。簡化後,每個邏輯核心擁有獨立緩存與寫緩衝區。
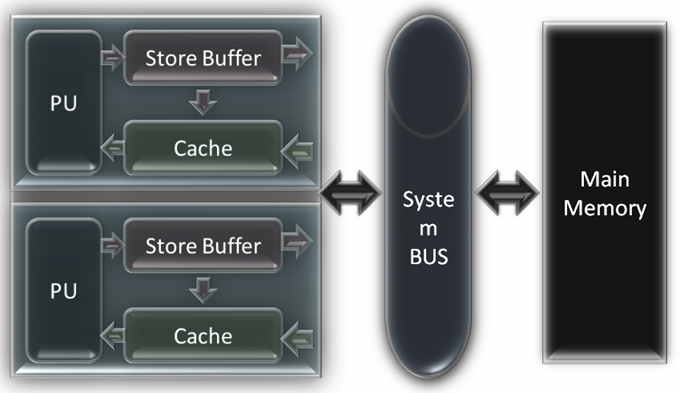
讀取流程: 先查當前 Cache,命中則返回;未命中則向總線發請求,獲令牌後讀主存,加入緩存並返回。
寫入流程: 寫操作壓入 Store Buffer 隊列,檢查後續讀操作若訪問同地址則更新 Cache,最後適當時機向總線發寫請求,獲令牌後將 Store Buffer 結果寫入主存。
嚴格說應稱「記憶體訪問指令重新排序」。它是優化 CPU 與總線效能的關鍵軟體因素。核心頻率、位寬等硬體條件固定時,記憶體訪問方式直接決定 CPU 整體效能。CPU 訪問高速緩存速度約為主存 100 倍,更好的訪問方式與更高命中率能大幅提升性能。統計表明,緩存未命中(訪問主存)代價約為主存未命中(訪問硬盤)的 10 倍。
Memory Reordering 必有度——即 Memory Model——平衡兩極端:
i=1; i++; 結果可能 0、1、2)。辯證看:正確性第一,效能第二。Memory Model 實現兩者間搖擺。偏向 A 稱強模型,偏向 B 稱弱模型。x86/AMD64 屬強模型,IA-64 屬弱模型。
x86 與 AMD64 原則極近,以 AMD64 代表討論。其多核心實現原則:
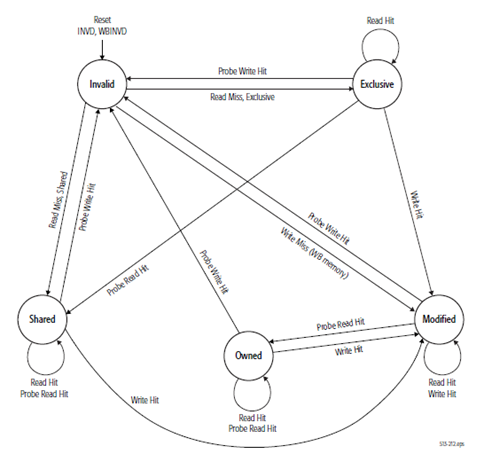
此模型嚴格,且 AMD 文檔給出 Memory Coherency and Protocol 保證:核心內 Store Buffer 排隊的寫操作,可被動被其他 CPU 觀察,或主動廣播使其他核心對應緩存行無效。綜合原則與 Store Buffer 處理,AMD64 基本可視為按編程順序執行。除多線程共享數據需必要同步外,.NET 程序員無需深究底層細節。
Intel 規格文檔第 8 章第 2 節詳述 IA-64 模型。單處理器原則摘譯:讀讀不重排、寫不跟舊讀排、主存寫寫不重排、不同地址讀可與較早寫排序(同地址除外)、I/O/鎖/序列化指令不重排、柵欄指令限制等。多處理器下,單處理器內部原則仍適用,處理器間遵循:單處理器寫操作被所有處理器以相同順序觀察、不同處理器寫不重排、遵循邏輯因果關係、第三方觀察到一致寫順序、鎖指令有全序。
原則看來 IA-64 採弱模型,但關鍵在於維護記憶體一致性機制。IA-64 為性能,一致性機制對訪問排序干預較少。關鍵規定:「Intra-Processor Forwarding Is Allowed」。
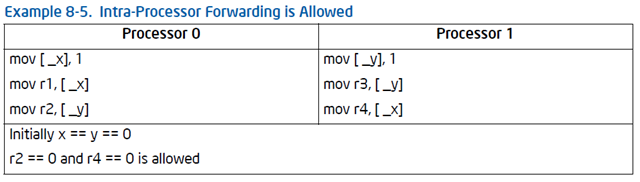
意即:寫緩存內緩存的寫操作,在最終提交前,僅能被所屬處理器觀察。其他處理器無法預判該寫操作。若一系列寫操作為創建記憶體物件,且全被緩存,則其他處理器看來,該物件根本未創建!
考慮寫緩存,文首引入的 volatile 單例實現其實有問題。volatile 僅保證標記欄位不被優化至高速緩存。IA-64 下這僅保證高速緩存與主存一致性,未考慮寫緩存對多處理器下物件創建的影響。其二,volatile 欄位始終不被高速緩存,代價過高。單例需求是物件唯一性,volatile 特性僅在 new 時需要,創建後反成性能累贅。
分析 AMD64 與 IA-64 規範,使用 Thread.MemoryBarrier() (全柵欄) 可有效改進:
public class Singleton {
    private static object syncRoot = new object();
    private Singleton instance;
    private Singleton() { }
    public Singleton Instance {
        get {
            if (instance == null) {
                lock (syncRoot) {
                    if (instance == null) {
                        Singleton singleObj = new Singleton();
                        System.Threading.Thread.MemoryBarrier();
                        instance = singleObj;
                    }
                }
            }
            return instance;
        }
    }
}
為免贅長,本文聚焦 CPU 記憶體訪問模型,未涉及:
Interlocked 類操作及其重要作用。撰寫此文耗費不少時間,為嚴謹性細讀 AMD64/IA-64 規格文檔多處理器與記憶體系統章節。期間見「0BUG門」事件,願多討論少攻擊,理不辯不明,尊重事實。限於寫作水平,望海涵指正。