自 CLR 2.0 起,執行緒集區經歷了多次重大重構。隨著多核架構的普及,以及將既有應用程式並行化或編寫新並行代碼的需求激增,這些趨勢成為 CLR ThreadPool 改進的核心驅動力。在 MSDN Magazine 2008 年 12 月號的「CLR 內幕」專欄《CLR 中的線程管理》中,筆者曾探討過並發控制與干擾資訊等議題。本文將深入剖析 CLR 4.0 ThreadPool 如何解決這些問題、相關實現選項及其行為影響,重點闡述自動化並發控制的實現方法,並簡述 ThreadPool 架構。
注意:本文討論的實現細節在未來版本中可能變更。但對於設計新並發應用、利用並發技術改進舊系統,或使用 ASP.NET 與平行擴充功能(均建構於 CLR 4.0 之上)的開發者而言,理解當前 ThreadPool 行為極具價值。
線程池提供線程管理、不同類型並發的抽象、以及並發操作限制等核心服務,減輕開發者手動管理的負擔。對新手友善,對專家則能讓其專注於業務邏輯。ThreadPool 支援跨平台可移植性(如 Mac OS 上運行 .NET 應用)。
系統涉及多種並發面向,最相關者包括:CPU 並行性、I/O 並行性、計時器與同步、負載平衡與資源利用率。ThreadPool 擁有兩套獨立實現:
本文聚焦於工作線程 ThreadPool 的並發限制策略。相關 API 為 QueueUserWorkItem,將工作項排隊執行,ThreadPool 自動「計算」最佳運行線程數。
「並發控制」實為「並發限制」——即特定時間允許執行工作的線程數,旨在防止資源爭用導致總吞吐量下降。CPU 並行性涉及參數極多:任意時刻可同時運行多少工作項、核心數、不同工作負載的優化等。理論上「每 CPU 一線程」最優,但若負載頻繁阻塞,會浪費 CPU 時間;實際上難以確定最優線程數,因完成時間與到達頻率(與 I/O 阻塞相關)難以預測。
最早嘗試根據觀測到的 CPU 利用率優化,增加線程使 CPU 忙碌。此法處理長時間或不確定負載有效,但度量標準易誤導。例如大量記憶體分頁時 CPU 利用率極低,增加線程反而加劇記憶體壓力、降低利用率;高爭用下 CPU 時間耗於同步而非實際工作,增線程只會惡化情況。
此法適用於 I/O ThreadPool,但工作線程 ThreadPool 需更高抽象層級以提供可移植性與資源管理。若創建數千線程,資源爭用成大患,且開發者仍需考慮並發,違背線程池初衷。
近期採用吞吐量(單位時間完成工作項數)作為優化度量。CPU 利用率極低時增線程觀察吞吐量變化:提升則繼續增,下降則減線程。此法較前者合理,因考慮完成工作量而非單純資源使用。但吞吐量受多因素影響(如工作項大小),優化極難。
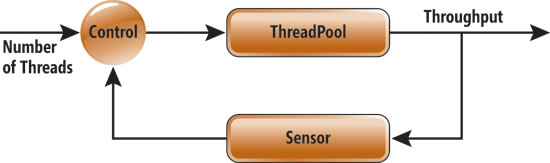
CLR 4.0 引入控制理論中的爬山演算法。此技術依輸入/輸出回饋迴路自動優化:在小時間間隔監測系統輸出,分析影響受控輸入的因素,回饋演算法以優化輸入。在工作線程 ThreadPool 中,輸入為並發層級(同時執行工作的線程數),輸出為吞吐量(見圖 1)。
演算法觀測增減線程導致的吞吐量變化,決定增減方向(見圖 2)。將吞吐量建模為並發層級的多項式函數,增線程至函數最大值(約 20),吞吐量下降則減線程。每間隔對吞吐量採樣平均,用於下一間隔決策。
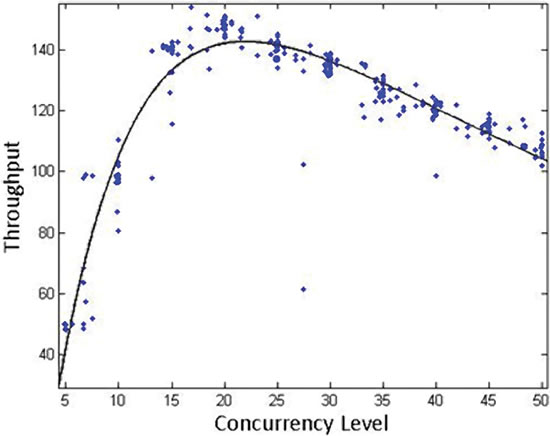
實際系統中,建模函數非靜態目標(圖 2 黑曲線 vs 藍點),難測量微小變化。更嚴重的是「干擾資訊」——系統環境導致的度量差異(OS 活動、垃圾回收等),使得難以確認輸入輸出的因果關係。ThreadPool 中觀測到的輸出多為干擾資訊。例如:增加少許線程不改變輸出;觀測到的改進可能與並發層級無關(見圖 3)。
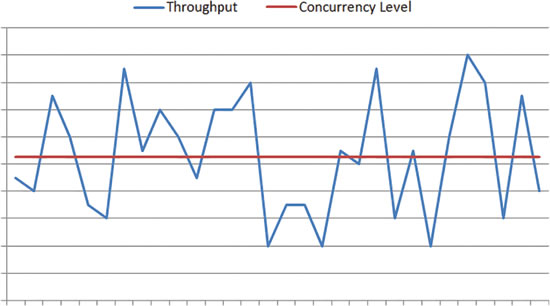
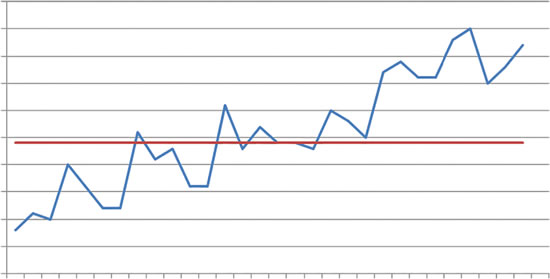
圖 3 上圖:線程數(紅)不變時吞吐量(藍)仍波動,此為干擾資訊。下圖:吞吐量整體提升但線程數不變,改進源於其他參數。
信號處理常用於從信號中提取模式。將並發層級(輸入)與吞吐量(輸出)視為信號,故意修改並發層級為已知週期振幅的「波形」輸入,在輸出中尋找原始波形模式,即可區分干擾資訊與實際輸入效果(見圖 4)。
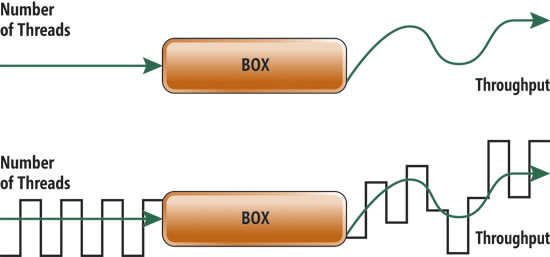
採用帶通濾波器或匹配濾波器技術,從雜亂輸出中提取目標波形。具體演算法使用離散傅立葉變換 (DFT) 獲取波形振幅與相位資訊,判斷輸入對輸出的影響。圖 5 展示運行 600 秒以上工作負載的行為。
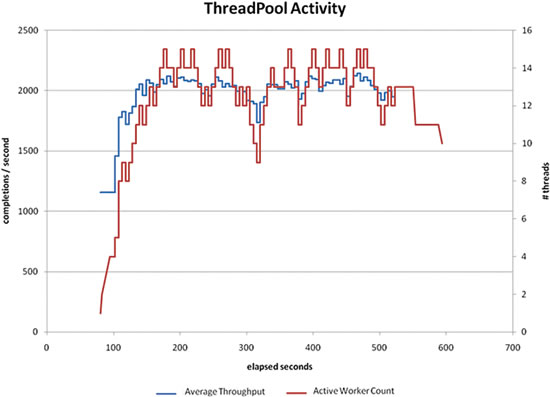
圖 5 中紅波形對應輸入,藍波形對應輸出。線程數浮動不代表創建/銷毀線程,而是線程在池中保持「活動」狀態但未執行工作。改進後的方法不建模吞吐量曲線,只確定輸入變更是否改善輸出。人為引入的變更確實產生觀測效果(最大觀測線程數 20,對多線程場景合理)。
缺點:因人為引入波形,最優並發層級需至少滯後一線程生效;調整較慢(較 CPU 利用率法慢),需收集足夠數據穩定模型,速度取決於工作項長度。此法非完美,表現隨負載異,但較前法有顯著進步。最適合短小工作項(< 250ms,尤 < 10ms 環境表現優異)。
ThreadPool 整合高端工程演算法自動決策,讓開發者專注核心功能。並發控制演算法隨技術進步與場景需求(如測量有用工作進度)演進。CLR 4.0 目標為自動確定可同時有效運行的工作項數,優化吞吐量。受干擾資訊與負載類型影響,優化非易事,且假設每工作項皆為有用工作段。當前設計深受 ASP.NET 與平行框架影響,在這些場景表現近乎完美。通常 ThreadPool 能高效執行工作,但開發者應知悉:特定負載或多 ThreadPool 同時運行時可能出現意外行為。