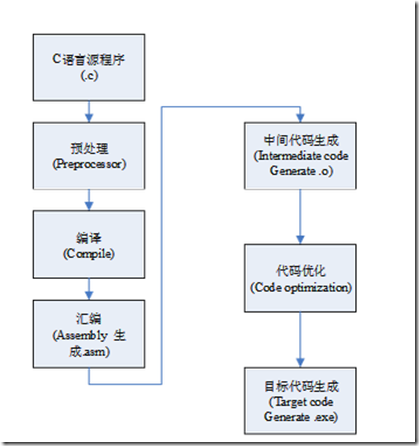
C 程式從文字原始碼變成可在機器上執行的二進位檔案,經歷了預處理、編譯、組譯、連結四大階段。每個階段都有其獨特的任務與產出物,深入理解這一流程,對排查編譯錯誤、優化效能、進行跨平台開發都大有裨益。
編譯器讀取原始程式(字元流),經過詞法分析、語法分析,將高階語言指令轉換為功能等價的組合語言代碼,再由組譯器轉為機器語言,最後由連結器依據作業系統可執行檔格式(如 ELF, PE)將多個目標檔與函式庫整合,生成最終可執行程式。
C 原始程式 (.c)
   ↓ 預處理
預處理後輸出 (.i / .c)
   ↓ 編譯、優化
組合語言代碼 (.s / .asm)
   ↓ 組譯
目標檔 (.o / .obj)
   ↓ 連結
可執行檔 (.exe / .elf / .axf ...)
預處理器處理以 # 開頭的偽指令與特殊符號,主要工作為「替換」:
#define Name TokenString 將程式中所有 Name 替換為 TokenString(字串常量內的除外);#undef 取消定義。#ifdef, #ifndef, #else, #elif, #endif 根據巨集定義決定保留或捨棄代碼區塊。#include "file" (當前目錄優先) 或 #include <file> (系統目錄如 /usr/include) 將標頭檔內容完整展開插入。避免重複定義,促進代碼複用。__LINE__ (當前行號), __FILE__ (當前檔名) 等被替換為對應值。輸出檔不再包含任何巨集、條件編譯指令、特殊符號,語義與原始檔相同,內容卻大不同。
編譯器對預處理輸出進行詞法/語法分析,生成中間代碼或直接產出組合語言。優化分兩層:
優化後的組合語言需經組譯器轉為機器指令才能執行。
將組合語言一對一翻譯為目標機器指令,產出目標檔。目標檔由段組成,至少包含:
UNIX 系統下目標檔三類型:
組譯器產出的是第一類;後兩類需連結器進一步處理。
解決目標檔間的符號引用(跨檔案函式呼叫、全域變數存取、函式庫函式),將分散的目標檔合併為單一可執行整體。
從靜態函式庫(.a, .lib)中將呼叫到的函式代碼複製到最終可執行檔中。優點:執行時無外部依賴;缺點:檔案體積大、記憶體佔用高、升級函式庫需重新連結。
可執行檔僅記錄共享物件(.so, .dll)名稱與少量登記資訊。執行時由動態連結器將共享物件映射至進程虛擬位址空間,解析符號地址。優點:檔案小、多進程共享同一實體代碼節省記憶體、函式庫升級無需重連結;缺點:啟動略慢、可能遇到「DLL Hell」版本衝突、極少數情況下效能損耗。
完整編譯流程極其複雜,涉及編譯器理論、硬體架構、工具鏈細節。工程師日常通常只需關注「編譯(原始碼→目標碼)」與「連結(目標碼+函式庫→可執行檔)」兩大階段,但在遇到疑難雜症(如連結錯誤、執行時崩潰、效能瓶頸)時,深入理解各階段機制將助你抽絲剝繭、定位根因。多實踐、多思考,方能臻於化境。