B+ 樹是檔案系統與資料庫索引的核心資料結構。本文基於嚴蔚敏/吳偉民版《資料結構》第 9 章源碼,系統解析 B+ 樹定義、與 B 樹差異、關鍵操作邏輯與測試驗證。
| 特性 | B 樹 | B+ 樹 |
|---|---|---|
| 關鍵字分佈 | 所有節點均含關鍵字 | 僅葉節點含完整關鍵字與記錄指針 |
| 非葉節點角色 | 數據+索引 | 純索引(引導查找) |
| 葉節點連結 | 無 | 雙向鏈表串聯,支援範圍查詢 |
| 查找終止條件 | 任意節點命中即停 | 必須達到葉節點 |
| 階數定義 | n 棵子樹 → n-1 個關鍵字 | n 棵子樹 → n 個關鍵字 |
// B+Tree.h
#define MAX_KEYS 3  // 階數 m = 4,最多 3 個關鍵字

typedef struct BPNode {
    int keynum;                    // 當前關鍵字數
    struct BPNode *parent;         // 雙親指針
    KeyType key[MAX_KEYS + 1];     // 關鍵字向量 (0 閒置)
    struct BPNode *ptr[MAX_KEYS + 1]; // 子樹指針
    Record *recptr[MAX_KEYS + 1];  // 記錄指針 (僅葉節點有效)
    struct BPNode *next;           // 葉節點鏈表指針
} BPNode, *BPTree;
// B+Tree.c
Result SearchBPTree(BPTree T, KeyType K) {
    BPTree p = T, q = NULL;
    int found = 0, i = 0;

    while (p && !found) {
        i = SearchNode(p, K);  // 節點內二分/順序查找
        if (i > 0 && i <= p->keynum && p->key[i] == K) found = 1;
        q = p;
        p = p->ptr[i];         // 移至子樹
    }

    if (found) {
        // 非葉節點命中,需繼續下沉至葉節點獲取記錄指針
        while (p) {
            q = p;
            p = p->ptr[0];  // 最左子樹
        }
        return (Result){q, SearchNode(q, K), 1};
    } else {
        return (Result){q, i, 0}; // 返回插入位置
    }
}
keynum < m-1),直接插入有序位置next 指針< ⌈m/2⌉ - 1(下溢),嘗試:
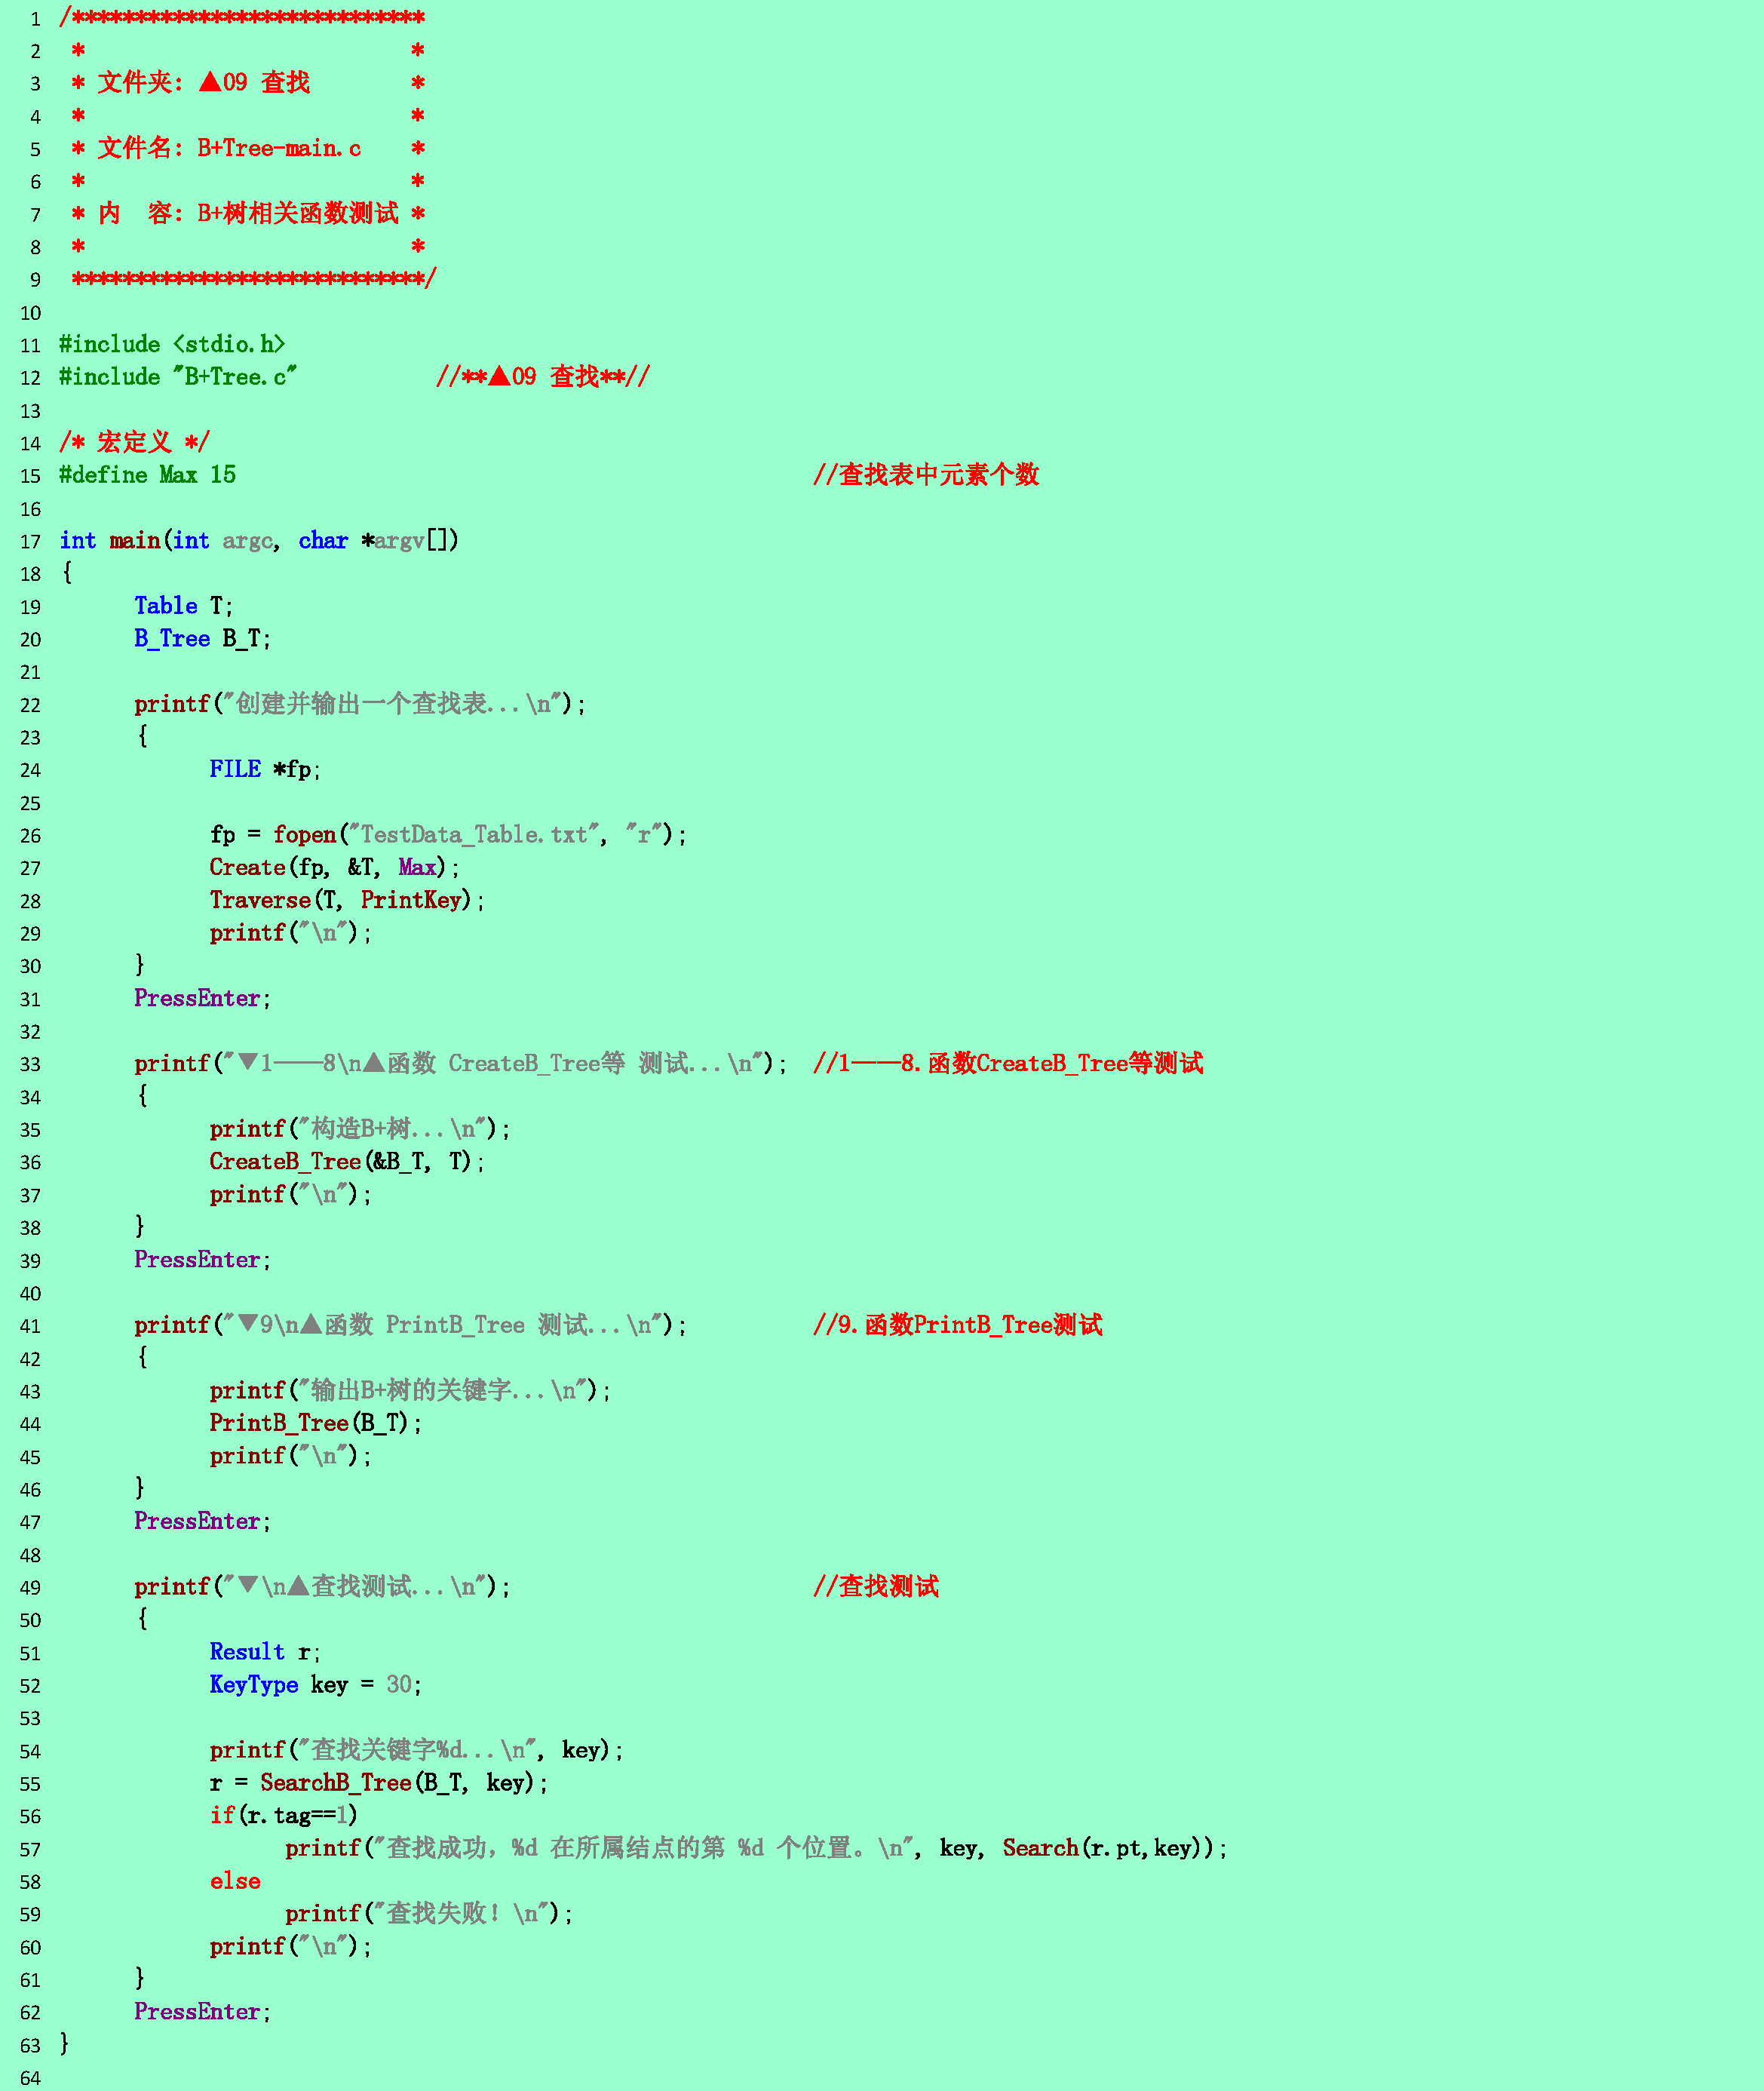
// B+Tree-main.c
int main() {
    BPTree T = NULL;
    // 讀取測試數據 TestData_Table.txt
    // 依次插入、查找、遍歷葉節點鏈表驗證有序性
    // 輸出樹結構圖形化表示
}
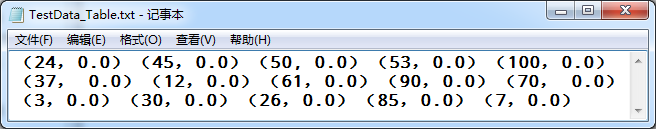
測試數據(TestData_Table.txt):
25 30 40 50 60 70 80 90 100
10 20 30 40 50 60 70 80 90
...
測試結果:
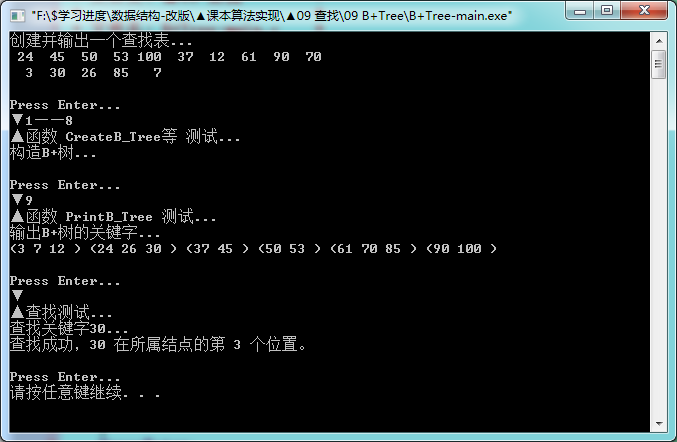
B+ 樹以「非葉純索引、葉節全數據、葉鏈支援範圍」三大特性,成為關係型資料庫(MySQL InnoDB、PostgreSQL)、檔案系統(NTFS、ext4、ReFS)、鍵值存儲(LevelDB、RocksDB)的標準索引結構。掌握其核心邏輯,是後端存儲引擎開發的必修課。