傳統匯編語言最快但開發難;Intel SSE SDK 提供兩種高級機制:Intrinsics 庫(C 函數封裝指令)與 C++ 類(封裝新數據類型操作),開發難度降低但性能略有下降。三者在執行速度與開發難度間權衡:
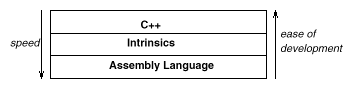
圖六:不同開發環境下執行速度與開發難度的權衡
_asm {
    push esi; push edi;
    ; a 在 xmm1, b 在 xmm2
    mov xmm0, xmm1; mulps xmm0, xmm2;
    ; 結果在 xmm0
    pop edi; pop esi;
}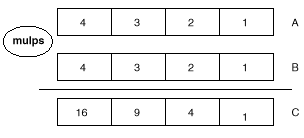
圖七:包裹乘法計算示意
包含 xmmintrin.h。定義 __m128 類型存 4 個 float。指令對應 C 函數,如 addps → _mm_add_ps。
乘法示例:
__m128 a,b,c;
a = _mm_set_ps(4,3,2,1); // 參數順序:高位到低位
b = _mm_set_ps(4,3,2,1);
c = _mm_mul_ps(a,b);包含 fvec.h。構造函數相當於 _mm_set_ps,運算符重載極簡潔:
F32vec4 a(4,3,2,1), b(4,3,2,1), c(0,0,0,0);
c = a * b;僅 Intel C/C++ 編譯器與 Microsoft Macro Assembler 6.11d+ 支援 SSE。Intel 編譯器已集成 Visual Studio,可配置項目或文件級使用。
addps/addss, subps/subss, mulps/mulss, divps/divss, sqrtps/sqrtss, maxps/maxss, minps/minss
andps, andnps, orps, xorps
cmpps/cmpss, comiss, ucomiss
shufps, unpckhps, unpcklps
cvtpi2ps/cvtpi2ss, cvtps2pi/cvtss2si
movaps, movups, movhps, movlps, movmskps, movss
ldmxcsr, stmxcsr, fxsave, fxrstor
maskmovq, movntq, movntps, prefetch, sfence
pextrw, pinsrw, pmaxub/pmaxsw, pminub/pminsw, pmovmskb, pmulhuw, pshufw
前節已展示三種實現。
無 SSE 只能循環逐對比。SSE 用 cmpps(2 操作數 + 比較類型立即數),結果存第一操作數:真為 0xFFFFFFFF,假為 0。可用 movmskps 將 4 個結果映射到通用寄存器各 1 位。
示例:cmpps xmm0, xmm1, 1; movmskps eax, xmm0; test eax, 5; je match13 (比較類型 1 為小於)。
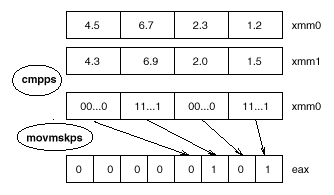
圖八:比較運算示意
C 代碼 a = (a < b) ? c : d; 涉及分支預測失敗風險。SSE 無分支實現:
; xmm0=a, xmm1=b, xmm3=c, xmm4=d
cmpps xmm0, xmm1, 1      ; 比較 a
利用邏輯指令實現無分支選擇,顯著提升性能。