SSE 指令僅操作 128 位新數據類型。若應用使用自有數據格式,執行 SSE 前需轉換為新格式,後再轉回,此過程稱為「Data Swizzling」,消耗核心週期。頻繁轉換嚴重拖慢性能,必須重視。
3D 應用常用結構體數組 (AoS) 存頂點:
struct Point { float x, y, z; };
Point dataset[N]; // AoS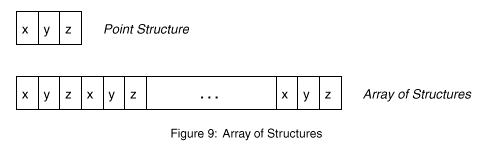
圖九:結構數組 (AoS)
SSE 優勢在於同時處理多頂點同一分量(如 4 個 x 座標)。需重組為結構數組 (SoA):
struct Point { float *x, *y, *z; }; // SoA:每分量獨立數組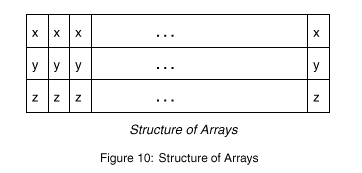
圖十:結構數組 (SoA)
新數據類型變量強烈建議 16 字節邊界對齊。可用編譯器參數或聲明時加 __declspec(align(16))。直接聲明 __m128 類型時編譯器自動對齊。
例:__declspec(align(16)) float[4] myVar;
malloc/new 默認不保證 16 字節對齊。解決:手動調整指針對齊,或用 _mm_malloc/_mm_free(保證 16 字節對齊)。
用 __m128 存 4 float 後,難直接訪問單個元素。常見繞路:拷貝到 float 數組修改再轉回(慢),或映射到 float 數組(不當則出錯)。
解決:定義聯合類型,關聯 __m128 與 float[4],編譯器自動對齊,且可直接訪問元素:
union sse4 { __m128 m; float f[4]; };使用 SSE 前必須檢測 Pentium III。方法一:cpuid 指令檢查 EDX 第 25 位(SSE 位)。方法二:嘗試執行 SSE 指令捕獲異常判斷是否有硬體/模擬支援。代碼見原文。
列出 Intel 官方手冊、優化指南、VTune、編譯器文檔等權威資料。
三種實現對比:
// Assembly
_asm {
    mov edi, a; mov esi, b; mov edx, c; mov ecx, 100;
loop:
    movaps xmm0, [edi]; movups xmm1, [esi];
    mulps xmm0, xmm1; movups [edx], xmm0;
    add edi,16; add esi,16; add edx,16; dec ecx; jnz loop;
}

// Intrinsics
__m128 m1,m2,m3;
for(int i=0;iunion sse4 { __m128 m; float f[4]; };
class sVector3 {
sse4 val;
public:
sVector3(float x,float y,float z){ val.m=_mm_set_ps(0,z,y,x); }
float& operator[](int i){ return val.f[i]; }
sVector3& operator+=(const sVector3& v){ val.m=_mm_add_ps(val.m,v.val.m); return *this; }
float length() const {
sse4 m1; m1.m=_mm_sqrt_ps(_mm_mul_ps(val.m,val.m));
return m1.f[0]+m1.f[1]+m1.f[2];
}
friend float dot(const sVector3&, const sVector3&);
};
float dot(const sVector3& v1, const sVector3& v2){
sVector3 v(v1); v.val.m=_mm_mul_ps(v.val.m,v2.val.m);
return v.val.f[0]+v.val.f[1]+v.val.f[2];
}union sse16 { __m128 m[4]; float f[4][4]; };
class sMatrix4 {
sse16 val; sse4 sFuzzy;
public:
sMatrix4(float* fv){ /* 用 _mm_set_ps 初始化 4 行 */ }
float& operator()(int i,int j){ return val.f[i][j]; }
sMatrix4& operator+=(const sMatrix4& M){ /* 4 行 _mm_add_ps */ return *this; }
bool operator==(const sMatrix4& M) const { /* 用 _mm_cmplt_ps/_mm_sub_ps/_mm_max_ps/_mm_min_ps/_mm_movemask_ps 比較 */ }
sVector4 operator*(const sVector4& v) const { /* 逐行點積 */ }
// ... 私有輔助函數
};