在學習數據結構初期,我們了解到有序數組雖然支持二分查找(時間複雜度 O(log₂N)),但插入刪除極慢(O(N));鏈表雖然增刪極快(O(1)),但查找卻需遍歷(O(N))。有沒有一種結構能兼顧快速查找與快速插入?樹結構正是為了解決這一矛盾而生。
程序世界存在一條隱形的「複雜度守恆定律」:降低某方面複雜度,必然增加其他方面的複雜度。正如人際關係中沒有無緣無故的愛恨,數據結構也沒有無緣無故的優劣,只有權衡與取捨。
樹是圖的一種特例。節點代表數據實體,邊表示節點間的關聯路徑。在 Java 等面向對象語言中,節點常對應對象,邊則用引用實現(C/C++ 用指針)。
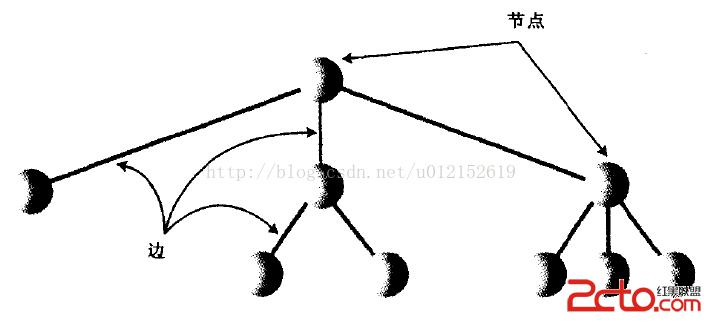
樹呈倒金字塔狀:頂層唯一的根節點連接第二層多個節點,依此類推。若每個節點最多擁有兩個子節點,稱為二叉樹;超過兩個則為多路樹。
關鍵術語(路徑、根、父/子節點、葉節點、子樹、層)可參考下圖直觀理解:
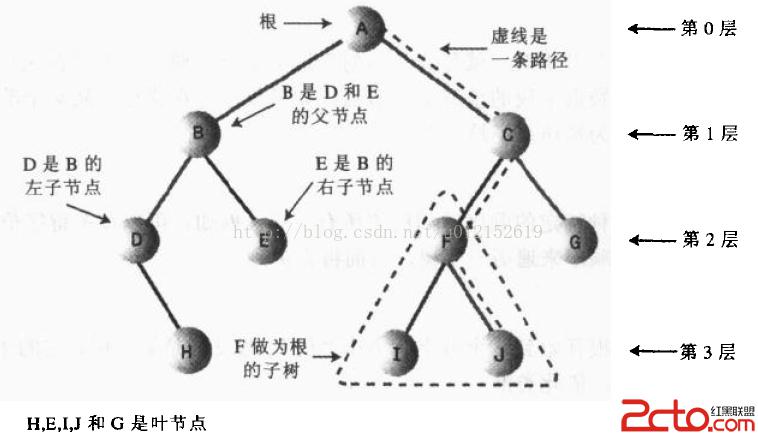
核心性質:從根到任意節點有且只有一條路徑。下圖違背此原則,因此不是樹:

二叉搜索樹是一種特殊且廣泛使用的二叉樹,特徵為:左子節點鍵值 < 父節點 ≤ 右子節點鍵值。這種有序特性使得查找、插入、刪除均能在 O(h) 時間內完成(h 為樹高)。
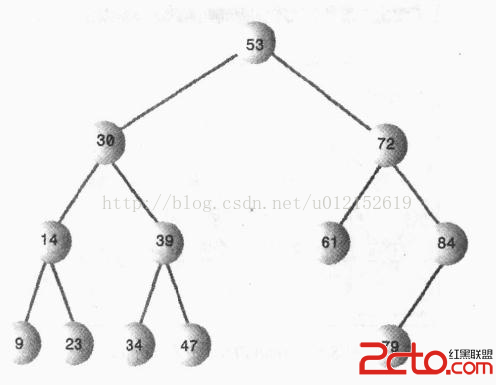
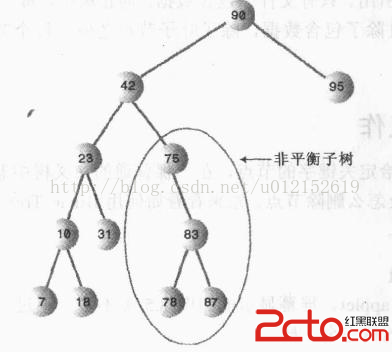
若節點多集中在根的一側,即為非平衡樹(退化為鏈表),效率嚴重下降至 O(N)。插入順序決定平衡性:隨機插入趨向平衡,有序插入導致極度不平衡。
public class Node {
    int age;
    String name;
    Node leftChild;
    Node rightChild;
    public Node(int age, String name) { ... }
    public void displayNode() { ... }
}
實際開發建議將數據封裝為獨立對象(如 Person 類),更符合面向對象原則。
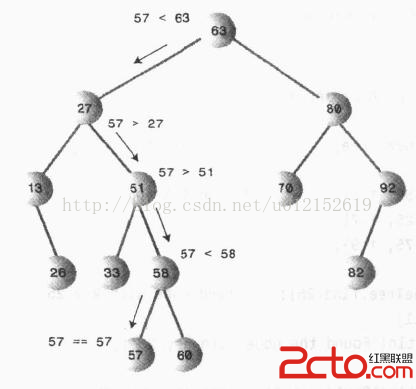
從根開始,目標值小於當前節點則向左,否則向右,直到找到或抵達葉節點仍未命中。
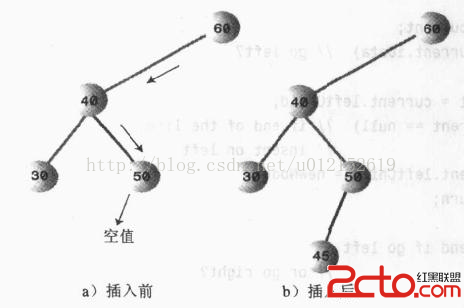
類似查找不存在的節點,找到插入位置後,將父節點對應引用指向新節點。
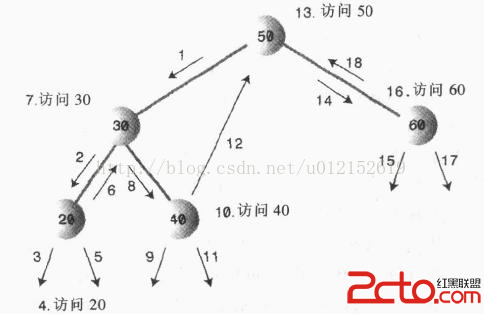
三種遞歸遍歷方式:
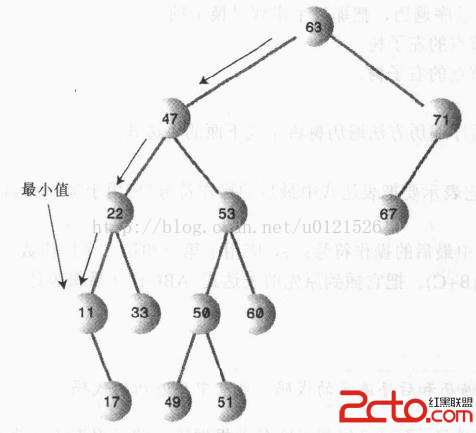
最小值:從根沿左子節點走到底;最大值:沿右子節點走到底。
需分三種情況處理:
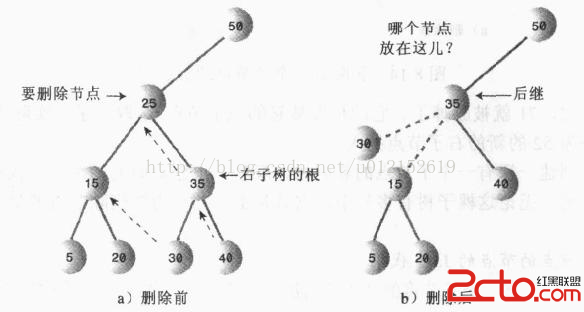
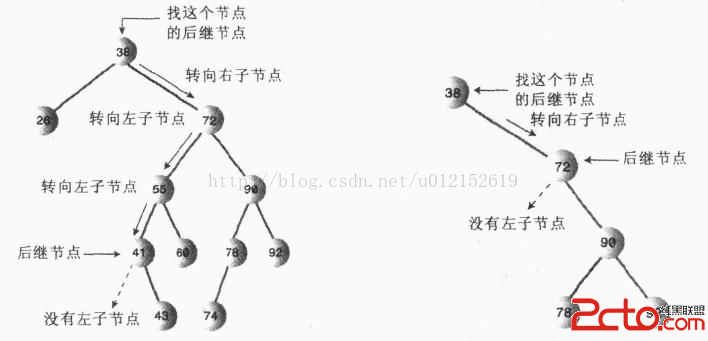
後繼節點查找:從右子節點起,沿左子節點走到底。
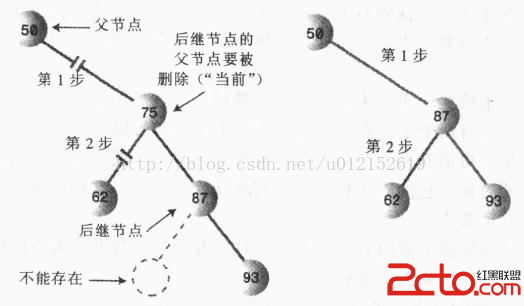
兩種子情況:
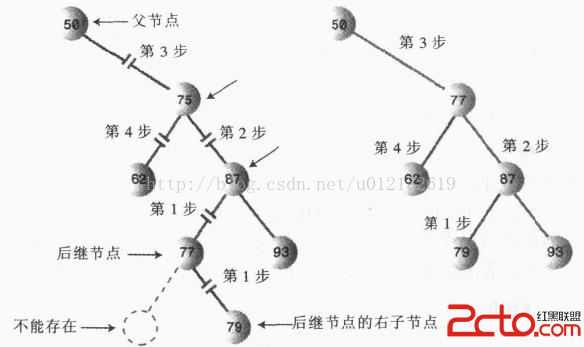
實務中若刪除操作較少,可採用「軟刪除」標記位簡化邏輯;本文為教學目的採用完整物理刪除實現。
包含查找、插入、刪除、三種遍歷、極值查找、樹深度計算、樹形打印等功能。關鍵代碼片段:
public class BinaryTree {
    private Node root;
    // 查找、插入、刪除、遍歷、getMax/getMin、getTreeDepth、displayTree 等方法
    // 刪除邏輯完整處理三種情況及根節點特殊情況
}
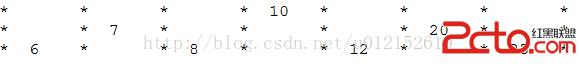
樹形打印效果(深度 3 示例):