這是一個編譯原理課程的實驗專案,目標是完成對 C 語言源碼的詞法分析。詞法分析是編譯器前端的第一關,負責將字符流轉換為標記流,為後續的語法分析奠基。本文將詳細拆解整體架構設計、核心模組實現細節,並附上完整源碼與運行截圖。
採用經典的繼承體系,分為基類 Base 與派生類 LexAn 兩層,職責劃分清晰:
封裝了詞法分析所需的各類字符判斷函數,為上層邏輯提供原子操作:
// 判斷字符類型:字母、數字、特殊符號等
int charkind(char c);
// 判斷空格是否可刪除
int spaces(char c);
// 判斷是否為字母
int characters(char c);
// 判斷是否為關鍵字
int keyword(char str[]);
// 判斷是否為合法標識符
int signwords(char str[]);
// 判斷是否為數字
int numbers(char c);
// 判斷是否為整數
int integers(char str[]);
// 判斷是否為浮點數
int floats(char str[]);
繼承 Base,封裝行級掃描、註釋清理、單詞提取與分類輸出:
// 處理每一行源碼
void scanwords();
// 清除註釋與多餘空格
void clearnotes();
// 根據狀態提取單詞
void getwords(int state);
// 判斷單詞類別並輸出
void wordkind(char str[]);
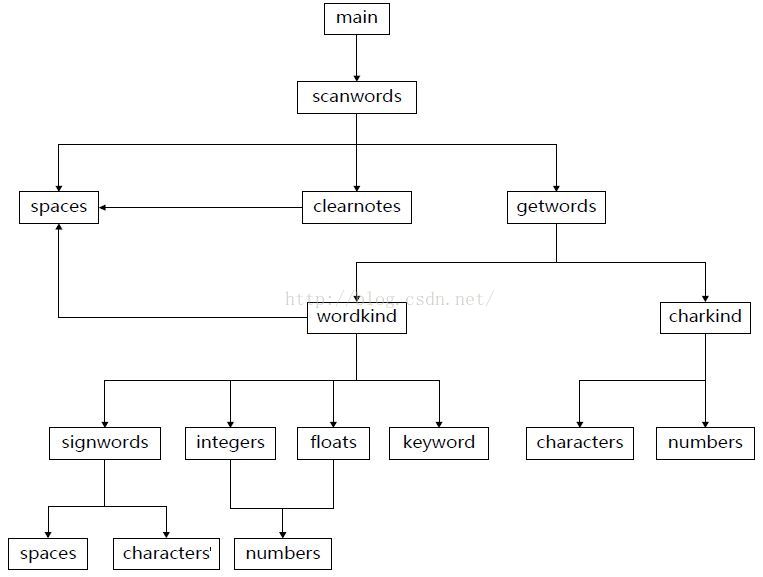
模組調用關係如下圖所示:
clearnotes()C 語言註釋分為單行 // 與多行 /* */ 兩種,處理邏輯如下:
/ 時向前看一個字符:若為 / 則將本行剩餘內容標記為註釋並截斷;若為 * 則尋找對應的 */,提取註釋內容並從行中移除,支持同行多個塊註釋。空格處理策略較為保守:僅刪除特殊符號與字母/數字之間的空格(如 if ( a >= b )),確保刪除後不改變語義。
void LexAn::clearnotes() {
    int i, j, k, noteCount = 0, flag = 0;
    char note[100];
    // 1. 處理註釋
    for (i = 0; bufferin[buffernum][i] != '\0'; i++) {
        if (bufferin[buffernum][i] == '"') { flag = 1 - flag; continue; } // 字符串常量內不處理
        if (bufferin[buffernum][i] == '/' && flag == 0) {
            if (bufferin[buffernum][i+1] == '/') { // 單行註釋
                for (j = i; bufferin[buffernum][j] != '\0'; j++)
                    note[noteCount++] = bufferin[buffernum][j];
                note[noteCount] = '\0';
                fprintf(fout, " [ %s ] ---- [ 註釋 ]\n", note);
                bufferin[buffernum][i] = '\0'; break;
            }
            if (bufferin[buffernum][i+1] == '*') { // 塊註釋
                note[noteCount++] = '/'; note[noteCount++] = '*';
                for (j = i+2; bufferin[buffernum][j] != '\0'; j++) {
                    note[noteCount++] = bufferin[buffernum][j];
                    if (bufferin[buffernum][j] == '*' && bufferin[buffernum][j+1] == '/') {
                        j += 2; note[noteCount++] = bufferin[buffernum][j];
                        note[noteCount] = '\0'; noteCount = 0;
                        fprintf(fout, " [ %s ] ---- [ 註釋 ]\n", note); break;
                    }
                }
                // 將註釋後內容前移覆蓋
                for (; bufferin[buffernum][j] != '\0'; j++, i++)
                    bufferin[buffernum][i] = bufferin[buffernum][j];
                if (bufferin[buffernum][j] == '\0') bufferin[buffernum][i] = '\0';
            }
        }
    }
    // 2. 處理多餘空格
    for (i = 0, flag = 0; bufferin[buffernum][i] != '\0'; i++) {
        if (bufferin[buffernum][i] == '"') { flag = 1 - flag; continue; }
        if (bufferin[buffernum][i] == ' ' && flag == 0) {
            for (j = i+1; bufferin[buffernum][j] != '\0' && bufferin[buffernum][j] == ' '; j++);
            if (bufferin[buffernum][j] == '\0') { bufferin[buffernum][i] = '\0'; break; }
            if (bufferin[buffernum][j] != '\0' &&
                (spaces(bufferin[buffernum][j]) == 1 || (i>0 && spaces(bufferin[buffernum][i-1]) == 1))) {
                for (k = i; bufferin[buffernum][j] != '\0'; j++, k++)
                    bufferin[buffernum][k] = bufferin[buffernum][j];
                bufferin[buffernum][k] = '\0'; i--;
            }
        }
    }
    // 3. 移除制表符
    for (i = 0, flag = 0; bufferin[buffernum][i] != '\0'; i++) {
        if (bufferin[buffernum][i] == '\t') {
            for (j = i; bufferin[buffernum][j] != '\0'; j++)
                bufferin[buffernum][j] = bufferin[buffernum][j+1];
            i = -1;
        }
    }
}
getwords()核心採用有限狀態機(FSM)設計,狀態編碼規則:
<字母, 1> <數字, 2> <$ _ , 3> <特殊符號, 4> <=, 5> <其他, 0>state = 0轉移邏輯概述:
關鍵代碼片段:
void LexAn::getwords(int state) {
    char word[100]; int charCount = 0, finish = 0, num, i, j, k;
    for (i = 0; bufferscan[i] != '\0'; i++) {
        switch (state / 10) {
            case 0: // 初始狀態
                switch (charkind(bufferscan[i])) {
                    case 1: word[charCount++] = bufferscan[i]; state = 10; break; // 字母
                    case 2: word[charCount++] = bufferscan[i]; state = 20; break; // 數字
                    case 3: word[charCount++] = bufferscan[i]; state = 30; break; // $ _
                    case 0: case 5: // 特殊符號或 =
                        word[charCount++] = bufferscan[i];
                        switch (bufferscan[i]) {
                            case '"': state = 41; break;      // 雙引號字符串
                            case '\'': state = 42; break;     // 單引號字符
                            case '(': case ')': case '{': case '}':
                            case '[': case ']': case ';': case ',': case '.':
                                state = 50; word[charCount] = '\0'; finish = 1; break; // 單字符界符
                            case '=': state = 43; break;      // 可能為 ==
                            default: state = 40; break;       // 其他運算符
                        } break;
                    default: word[charCount++] = bufferscan[i]; break;
                } break;
            case 1: // 標識符/關鍵字狀態
                // ... 接受字母數字$_, 否則結束並截斷超長標識符(>7字符)
            case 2: // 數字常量狀態
                // ... 處理小數點、進制前綴等
            case 3: // $ _ 開頭標識符狀態
                // ...
            case 4: // 特殊符號/常量詳細狀態
                // ... 字符串、字符、運算符多字符判斷
            case 5: // 輸出單詞並重置
                finish = 0; state = 0; charCount = 0; i--; wordkind(word); break;
        }
        if (bufferscan[i+1] == '\0') { word[charCount] = '\0'; wordkind(word); }
    }
}
注意:實驗要求標識符長度超過 7 字符需截斷,如需完整保留請刪除標註處代碼。
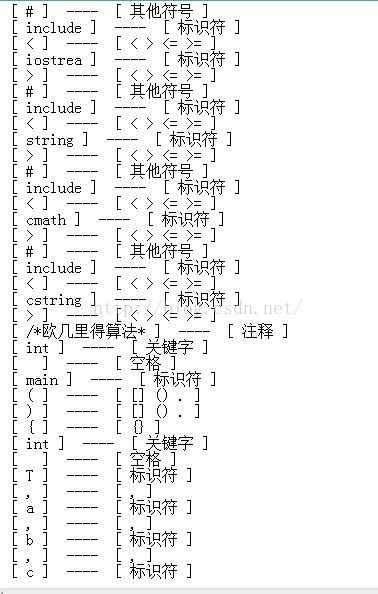
完整專案源碼已開源於 GitHub,歡迎 Star、Fork 學習交流。