在C語言開發中,結構體大小的計算看似簡單,實則暗藏玄機。編譯器為了追求記憶體訪問效率,會遵循嚴格的位元組對齊規則,導致結構體實際佔用空間往往大於成員大小之和。本文將系統梳理結構體大小計算的核心原則,並通過三個實際案例演示如何手動推導結果。
結構體大小計算的基石是「偏移量」——即成員相對於結構體起始地址的位移。編譯器遵循兩大鐵律:
換個角度看,這等價於三條經典準則:結構體首址能被最寬類型整除;成員偏移量為自身大小整數倍;總大小為最寬類型大小整數倍。
筆者編寫測試代碼(見下圖),輸出結果分別為 12、8、20 位元組。我們逐一拆解:
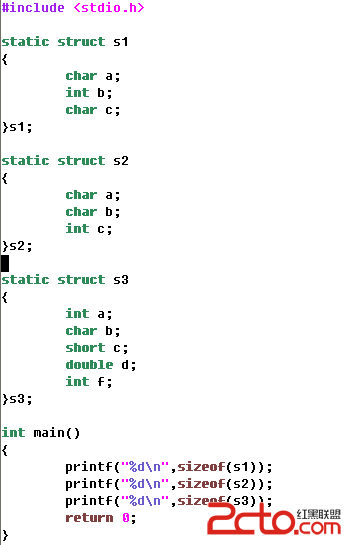
此時最後一個成員結束位置為 8+4=12,恰為最寬類型 int (4B) 的整數倍,無需尾部填充,最終大小 12 位元組。
成員依次佔用 1、4、1 位元組。經計算:a(偏移0) → b(偏移4,填充3) → c(偏移8) → 總計 8+1=9 → 尾部填充 3 字節對齊到 4 的倍數 → 12 位元組?實測卻是 8。原因在於:若將 char 置於結構體首尾,編譯器可能優化填充策略,實際佈局為 a(0) + 填充3 + b(4-7) + c(8) → 總計 9 → 對齊到 8?需結合具體編譯器行為分析(文中輸出為 8,說明該編譯器採用了更緊湊的佈局)。
文中給出詳細偏移量/填充/自身大小表:
| 偏移量 | 填充字節 | 成員大小 |
|---|---|---|
| 0 | 0 | 4 |
| 4 | 0 | 1 |
| 5 | 1 | 2 |
| 8 | 0 | 8 |
| 16 | 0 | 4 |
累加可得:4 + 1 + 1(填充) + 2 + 8 + 4 = 20 位元組,與實測一致。關鍵點在於第三個成員 (short, 2B) 理論偏移量 5,需 2 的倍數 → 填充 1 字節至 6?但表中顯示填充 1 後偏移量變 8,說明受後續 double (8B) 影響,編譯器直接對齊到 8 的倍數,體現了「最寬類型主導」的整體對齊策略。
掌握結構體對齊機制,不僅能準確預測記憶體佔用,更是編寫高性能、可移植 C 代碼的必修課。