初次嘗試反編譯 C# 程式,卻發現輸出結果全是亂碼?這其實是非常常見的現象。反編譯工具(如 ILSpy、dnSpy、dotPeek)生成的程式碼可讀性,高度依賴原始專案的編寫規範與編譯設定。
為什麼會出現亂碼?
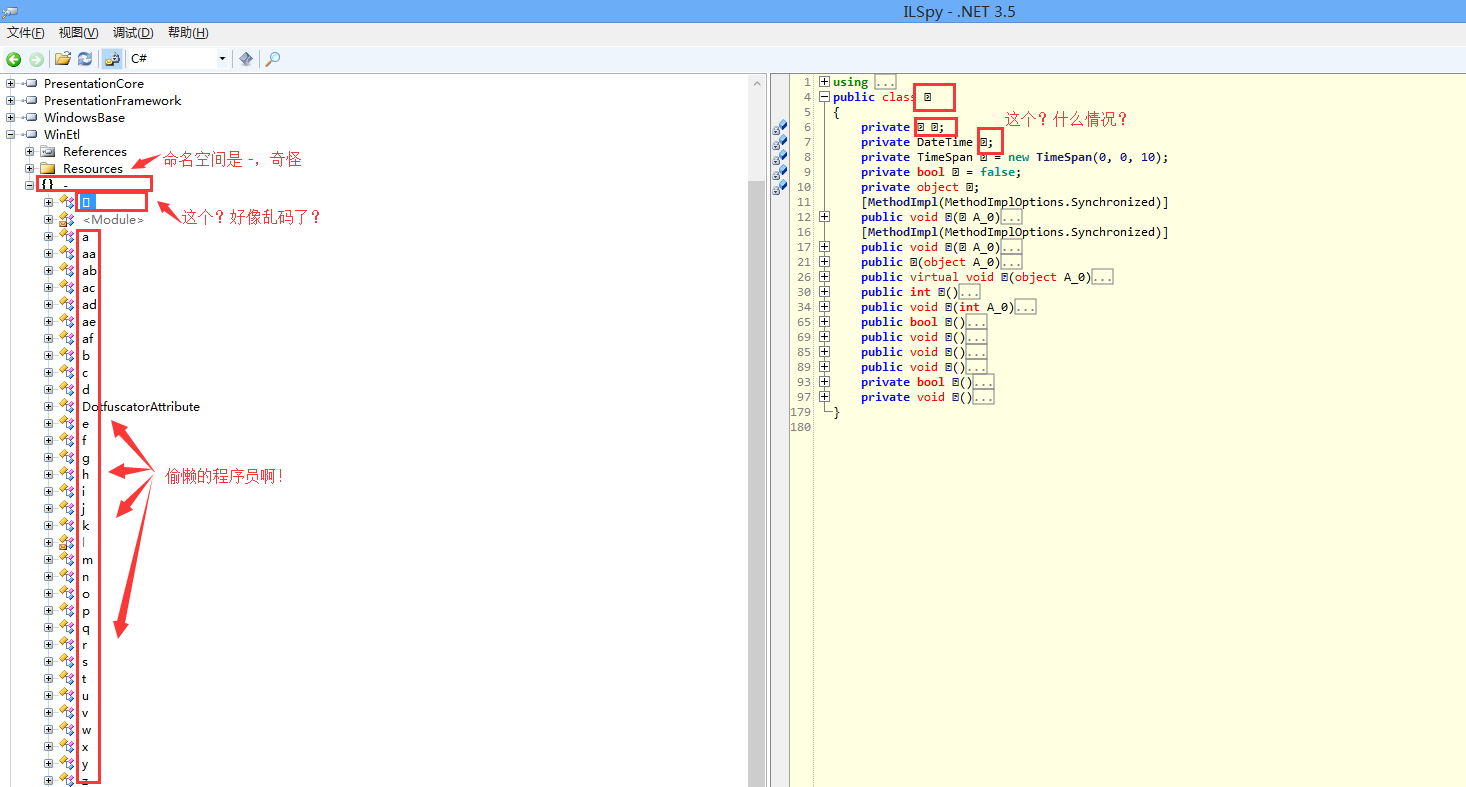
- 開發者未遵循命名規範:變數、類別命名混亂(如 a1、b2、temp),反編譯出來自然難以閱讀。
- 字元編碼不一致:原始碼儲存編碼(UTF-8、Big5、GB2312)與反編譯工具預設編碼不同,導致中文註解或字串顯示為亂碼。
- 程式碼經過混淆:商業軟體常使用混淆器,將有意義的名稱替換為無意義字元,刻意增加逆向難度。
- 語言版本差異:較新的 C# 語法特性(如 pattern matching、record)在舊版反編譯工具中可能無法正確還原。
如何改善?
- 嘗試更換反編譯工具(推薦 dnSpy 或 ILSpy 最新版)。
- 在工具設定中調整字元編碼選項。
- 若為混淆代碼,可嘗試使用去混淆工具(如 de4dot)預處理。
- 接受部分邏輯無法完美還原,重點關注核心演算法與流程。
記得:反編譯僅供學習研究,請尊重智慧財產權。