SQL Server 2005 引入四大排序視窗函數,皆需搭配 OVER (ORDER BY ...) 子句使用,支援 PARTITION BY 分組。本文以範例資料逐一剖析差異、語法、執行邏輯與實戰應用。
CREATE TABLE t_table (field1 INT, field2 VARCHAR(20));
INSERT INTO t_table VALUES
(10, 'A'), (20, 'B'), (30, 'C'), (30, 'D'), (30, 'E'), (40, 'F');
資料內容:
| field1 | field2 |
|---|---|
| 10 | A |
| 20 | B |
| 30 | C |
| 30 | D |
| 30 | E |
| 40 | F |
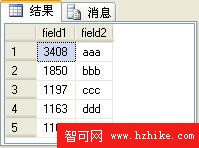
圖 1:原始資料
SELECT ROW_NUMBER() OVER (ORDER BY field1) AS rn, * FROM t_table;
圖 2:ROW_NUMBER 結果 (1,2,3,4,5,6)
OVER (ORDER BY ...) 中的排序**獨立於外層查詢 ORDER BY**,可不同:SELECT ROW_NUMBER() OVER (ORDER BY field2 DESC) AS rn, *
FROM t_table ORDER BY field1 DESC;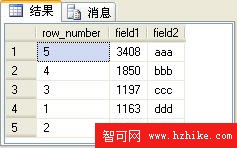
圖 3:OVER 排序與輸出排序分離
WITH cte AS (
    SELECT ROW_NUMBER() OVER (ORDER BY field1) AS rn, *
    FROM t_table
)
SELECT * FROM cte WHERE rn > 1 AND rn < 4 ORDER BY field1; -- 第 2-3 筆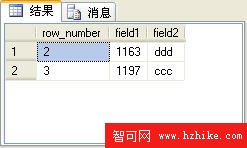
圖 4:分頁結果
⚠ 分頁時 **OVER 排序必須與外層 ORDER BY 一致**,否則序號可能不連續導致資料遺漏/重複。
SELECT * FROM (
    SELECT TOP 2 * FROM (
        SELECT TOP 3 * FROM t_table ORDER BY field1
    ) a ORDER BY field1 DESC
) b ORDER BY field1;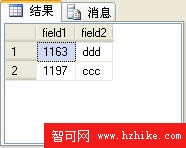
圖 5:傳統法結果 (無序號欄位)
SELECT RANK() OVER (ORDER BY field1) AS rk, * FROM t_table ORDER BY field1;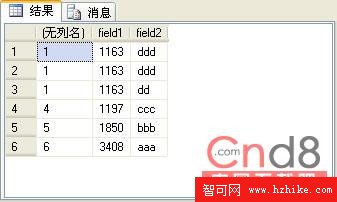
圖 6:RANK 結果 (1,2,3,3,3,6) —— 第 4 筆跳為 6
ORDER BY 值 → 同名次 (並列)。SELECT DENSE_RANK() OVER (ORDER BY field1) AS drk, * FROM t_table ORDER BY field1;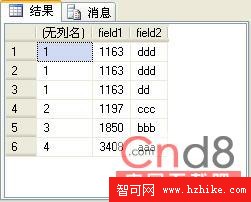
圖 7:DENSE_RANK 結果 (1,2,3,3,3,4) —— 第 4 筆為 4
| 函數 | 並列處理 | 序號連續性 | 適用場景 |
|---|---|---|---|
| ROW_NUMBER | 不並列 (強制展開) | 嚴格連續 | 分頁、唯一序號、ETL 流水號 |
| RANK | 並列同名次 | **跳號** (競賽式) | 成績排名、銷售排名、競賽名次 |
| DENSE_RANK | 並列同名次 | **不跳號** (密集式) | 等級劃分、分群標籤、連續層級編號 |
SELECT NTILE(4) OVER (ORDER BY field1) AS bucket, * FROM t_table;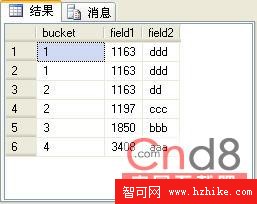
圖 8:NTILE(4) 結果 (6 筆資料分 4 桶 → 2,2,1,1)
-- 演算法邏輯 (Pseudocode)
IF (TotalRows % Buckets == 0)
    EachBucket = TotalRows / Buckets;
ELSE
    Base = TotalRows / Buckets + 1;           -- 前桶筆數 (較大)
    n = 1;
    WHILE ((TotalRows - Base*n) % (Buckets - n) != 0) n++;
    Remainder = (TotalRows - Base*n) / (Buckets - n); -- 後桶筆數 (較小)
前 n 桶各 Base 筆,後續各 Remainder 筆;-- 將客戶依消費金額分為 10 等分 (十分位數)
SELECT CustomerID, TotalAmount,
NTILE(10) OVER (ORDER BY TotalAmount) AS Decile
FROM CustomerSales;
-- 取前 10% 高價值客戶 (Decile = 10)
WITH cte AS (
SELECT *, NTILE(10) OVER (ORDER BY TotalAmount) AS Decile
FROM CustomerSales
)
SELECT * FROM cte WHERE Decile = 10;| 需求 | 推薦函數 | 理由 |
|---|---|---|
| 分頁、唯一流水號 | ROW_NUMBER | 嚴格連續、無並列干擾 |
| 競賽/銷售排名 (並列跳號) | RANK | 符合傳統排名直覺 |
| 等級/分群標籤 (並列不跳號) | DENSE_RANK | 層級編號連續、便於後續 JOIN/GROUP BY |
| 百分位/十分位/四分位分群 | NTILE | 內建等分邏輯、無需手算閾值 |
| 搭配 PARTITION BY 分組排序 | 全部支援 | 如各部門內部排名、各區域銷售分位 |
ORDER BY 欄位有索引支援 (覆蓋索引最佳)。PARTITION BY 會增加 Spools/Hash Match 成本,分組鍵選擇性高時效能較好。四大排序函數各有其語義精確對應的業務場景:**ROW_NUMBER 做分頁、RANK 做競賽排名、DENSE_RANK 做等級標籤、NTILE 做分位分群**。掌握「並列是否跳號」、「序號是否連續」、「桶分配演算法」三大核心差異,即可精準選型、撰寫高可讀、高效能的 T-SQL。配合 PARTITION BY 分組與 OVER 獨立排序特性,更能處理複雜的多維度排名分析需求。