某物流系統查詢運單明細,主表 TB_CWB (數百萬列)、從表 TB_CWBWEIGHT。透過預存程序參數 @CWB_NO 查詢單筆,但執行時間 7-16 秒;改為字面值常數後 < 1 秒。根因:**參數嗅探** 導致優化器依據參數值選擇「大資料量並行計畫」而非「單筆索引搜尋」。
DECLARE @CWB_NO VARCHAR(50) = '31301379874';
SELECT a.AWB_NO, a.BWB_NO, a.CWB_NO, a.ORIGIN, a.DEST, a.MODIFY_ON, a.CREATED_ON,
       a.CONSIGNOR_CUSTOMER_CODE, a.CONSIGNOR_CODE, a.CONSIGNOR_NAME, a.CONSIGNEE_NAME,
       a.CWB_STATUS, a.CWB_TYPE, ISNULL(a.PCS,0) AS PCS, a.BWBLIST, b.PWEIGHT
FROM TB_CWB AS a
LEFT JOIN TB_CWBWEIGHT AS b ON a.CWB_NO = b.CWB_NO AND b.AVAILABLE = 'Y'
WHERE a.AVAILABLE = 'Y'
  AND (a.CWB_NO = @CWB_NO OR
       (@CWB_NO IS NULL AND a.AWB_NO = NULL OR NULL IS NULL AND ... 多條件動態查詢模式 ...));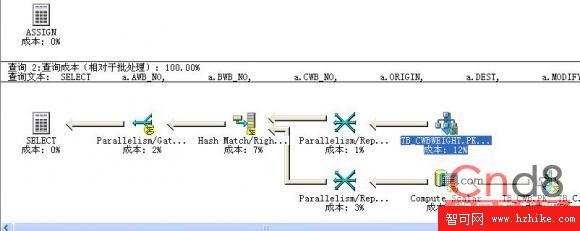
圖 1:並行掃描 + 雜湊聯結計畫 (預估大資料量)
@CWB_NO 的密度向量預估回傳大量列,選擇並行計畫。SELECT a.AWB_NO, a.BWB_NO, a.CWB_NO, a.ORIGIN, a.DEST, a.MODIFY_ON, a.CREATED_ON,
a.CONSIGNOR_CUSTOMER_CODE, a.CONSIGNOR_CODE, a.CONSIGNOR_NAME, a.CONSIGNEE_NAME,
a.CWB_STATUS, a.CWB_TYPE, ISNULL(a.PCS,0) AS PCS, a.BWBLIST, b.PWEIGHT
FROM TB_CWB AS a
LEFT JOIN TB_CWBWEIGHT AS b ON a.CWB_NO = b.CWB_NO AND b.AVAILABLE = 'Y'
WHERE a.AVAILABLE = 'Y'
AND (a.CWB_NO = '31301379874' OR
('31301379874' IS NULL AND a.AWB_NO = NULL OR NULL IS NULL AND ...));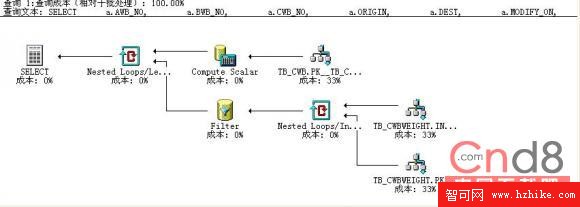
圖 2:巢狀迴圈聯結 + 索引搜尋計畫 (實際單列)
| 因素 | 影響 |
|---|---|
| 參數嗅探 | 編譯時嗅探首次執行參數值,鎖定計畫。若首次為 NULL/通用值,預估高基數 → 並行計畫;後續單值執行複用該計畫 → 慢。 |
| 動態查詢模式 (OR @Param IS NULL) | 導致優化器無法推斷實際選擇性,傾向保守估計 (高基數),產生通用並行計畫。 |
| 統計資訊過期/取樣率低 | 密度向量不準確,加劇預估偏差。 |
| 缺乏覆蓋索引 | 需回表查詢非索引欄位,增加 I/O。 |
SELECT ... FROM ...
WHERE ...
OPTION (RECOMPILE); -- 每次執行重新編譯,CPU 開銷換取計畫精準
適用:執行頻率中低、參數選擇性變化大、可接受編譯開銷。
SELECT ... FROM ...
WHERE ...
OPTION (OPTIMIZE FOR (@CWB_NO = '31301379874'));
適用:參數值分布已知、大多數查詢為高選擇性單值。
SELECT ... FROM ...
WHERE ...
OPTION (OPTIMIZE FOR UNKNOWN);
適用:參數值分布極不均勻、無明確代表值、避免極端計畫。
DECLARE @LocalCWB_NO VARCHAR(50) = @CWB_NO; -- 指派給區域變數
SELECT ... WHERE a.CWB_NO = @LocalCWB_NO ...; -- 優化器視為未知值,用平均密度估算DECLARE @SQL NVARCHAR(MAX) = N'SELECT ... WHERE a.CWB_NO = @CWB_NO ...';
EXEC sp_executesql @SQL, N'@CWB_NO VARCHAR(50)', @CWB_NO = @CWB_NO;
-- sp_executesql 會為不同參數值產生/快取獨立計畫 (參數化計畫)最徹底方案:每個不同選擇性參數值獲得專屬計畫,但會增加計畫快取壓力。
原文結論:預存程序中不應撰寫冗長複雜的單一 SQL,應拆解為多個簡單陳述式,搭配暫存表/表變數暫存中間結果,讓優化器針對每個簡單步驟生成最優計畫,並便於除錯、維護、統計資訊更新。
CREATE PROC usp_GetCWBDetail @CWB_NO VARCHAR(50)
AS
BEGIN
    -- 步驟 1:快速定位主鍵 (索引搜尋)
    SELECT CWB_NO, AWB_NO, BWB_NO, ...
    INTO #TmpMain
    FROM TB_CWB
    WHERE AVAILABLE = 'Y' AND CWB_NO = @CWB_NO;

    -- 步驟 2:關聯從表 (索引搜尋)
    SELECT m.*, w.PWEIGHT
    FROM #TmpMain m
    LEFT JOIN TB_CWBWEIGHT w ON m.CWB_NO = w.CWB_NO AND w.AVAILABLE = 'Y';
ENDsys.dm_exec_cached_plans 配合 query_plan XML 檢查 ParameterCompiledValue vs ParameterRuntimeValue)。參數嗅探是 SQL Server 優化器的雙面刃:善用則複用高效計畫,失效則導致災難性計畫錯配。掌握 OPTION (RECOMPILE/OPTIMIZE FOR)、動態 SQL、區域變數、拆解巨型查詢等工具箱,並建立「執行計畫異常 → 檢查參數嗅探 → 套用修正 → 驗證效能」的標準化調優流程,是 DBA 與開發者進階必修課。