聚集索引決定了資料表中資料的物理儲存順序。打個比方,它就像電話簿依照姓氏拼音排序——資料本身就是目錄。因為物理順序只能有一種,所以一張表只能擁有一個聚集索引(但可包含多欄組合索引)。
適用場景:
非聚集索引的葉節點存放的是索引鍵值 + 指向資料行的指標(Row Locator),而非資料本身。查詢時需先走索引樹,再透過指標回表取資料(Key Lookup)。
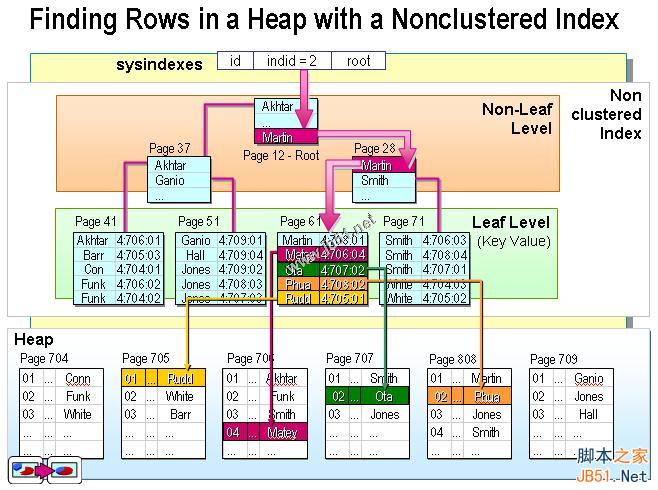
非聚集索引:葉節點為索引節點,含指標指向資料頁
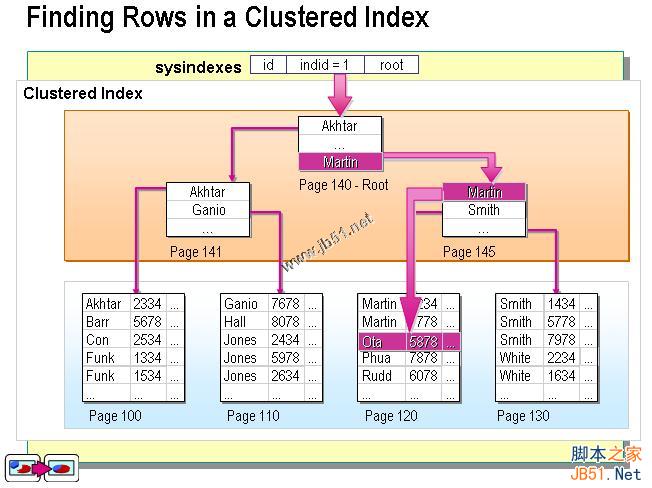
聚集索引:葉節點即資料節點
由此可知:目錄只能按一種規則排序 → 一表僅一聚集索引。
| 操作描述 | 聚集索引 | 非聚集索引 |
|---|---|---|
| 欄位常作 GROUP BY / ORDER BY | ✅ | ✅ |
| 返回範圍資料 | ✅ | ❌ |
| 極少不同值(如性別) | ❌ | ❌ |
| 少數不同值 | ✅ | ❌ |
| 大量不同值 | ❌ | ✅ |
| 頻繁更新的欄位 | ❌ | ✅ |
| 外鍵欄位 | ✅ | ✅ |
| 主鍵欄位 | ✅ | ✅ |
| 頻繁修改索引欄位 | ❌ | ✅ |
範例:若聚集索引建在日期欄,查詢某月份資料只需定位起訖頁;若是非聚集索引,則需逐筆回表,效能差距巨大。
SQL Server 預設在主鍵建立聚集索引。但若主鍵是自增 ID(業務無意義、極少範圍查詢),這浪費了寶貴的唯一聚集索引名額。
實測對比(1000 萬筆,近 3 個月 25 萬筆):
| 方案 | SQL 範例 | 耗時 |
|---|---|---|
| 僅主鍵聚集,無時間篩選 | SELECT ... FROM tgongwen | 128 秒 |
| 主鍵聚集 + 日期非聚集 | WHERE fariqi > DATEADD(day,-90,GETDATE()) | 54 秒 |
| 聚集索引建在日期欄 | WHERE fariqi > DATEADD(day,-90,GETDATE()) | 2 秒 |
結論:將聚集索引給高頻範圍查詢欄位(如日期),而非無意義 ID。
同樣查詢、同樣欄位,非聚集 vs 聚集索引差 27 倍。索引類型選擇比單純「有無索引」更關鍵。
複合索引首欄必須是最高頻查詢欄位。實測:
原則:前導列 = 最常用篩選欄位;次要列僅在「索引覆蓋」時加速。
延伸閱讀:《SQL Server 中的 SQL 語句優化與效率問題》