1. 死鎖多發表 → 職責分離
若某表頻繁死鎖,拆分寫入路徑:建立專屬 `InsertTable`、`UpdateTable`、`DeleteTable` 或暫存表,透過觸發器/排程/ETL 合併至主表。將鎖競爭分散到不同物件,降低衝突機率。
2. 叢集索引不一定要給 ID
習慣性將 `IDENTITY` 列設為叢集索引 (PK) 往往非最優。叢集索引決定**資料物理排序**。優化原則:
- 範圍查詢高頻欄位:如 `CreatedDate`、 `OrderDate`,利用物理鄰近性加速範圍掃描。
- 常用排序/分組欄位:避免額外排序運算符。
- 窄、唯一、遞增、靜態:叢集鍵會複製到所有非叢集索引葉層,寬鍵放大所有索引體積。
- 範例:待辦/待閱系統按時間倒序 → `CreatedDate` 做叢集索引 (降序) 極佳。
3. 大表拆分:縱向與橫向
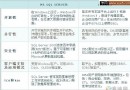
| 策略 | 做法 | 適用場景 |
|---|
| 縱向拆分 (垂直) | 將大欄位 (BLOB、長文本、低頻欄位) 移至擴展表,主表保留高頻窄欄位 | 主表掃描慢、行長導致頁面容納少、緩衝區命中低 |
| 橫向拆分 (水平/分區) | 依範圍 (時間)、雜湊 (租戶 ID)、列表 (地區) 將資料分散到多表/多檔案群組 | 單表超大、歸檔需求、多租戶隔離、平行查詢 |
指標:`sp_spaceused` 監控表大小、索引大小、未使用空間。
4. NOT NULL 約束:資料品質與效能雙贏
- **資料完整性**:強制業務必填欄位非空,防止髒資料。
- **效能優勢**:優化器可確知欄位無 NULL,簡化查詢邏輯 (如 `COUNT(*)` vs `COUNT(Col)`)、啟用更多優化路徑、節省 NULL 位圖空間 (每列 1 bit,大表可觀)。
- **索引效益**:叢集索引鍵、非叢集索引鍵**強制 NOT NULL**,避免 NULL 值導致的索引尋找失效/掃描。
5. 填充因子:被忽視的效能槓桿
- **含義**:索引建立/重建時,葉層頁面填滿百分比,預留空間給後續插入/更新。
- **預設 0/100**:頁面塞滿,插入導致分頁分裂、碎片、I/O 放大。
- **設定策略**:
- 叢集索引 + 隨機鍵 (GUID、複合鍵) → `FILLFACTOR=70~80` 減少分裂。
- 叢集索引 + 自增鍵 (IDENTITY) → **100 最佳**,永遠追加尾頁,無分裂,預留空間純浪費。
- 非叢集索引高頻更新/插入 → `80~90` 視更新頻率調整。
- 唯讀/歸檔表 → 100。
- **只在 REBUILD 時生效**:平時插入不維持填充因子,需定期重建恢復預留空間。
總結:設計即效能
資料庫設計階段的每個決策 (叢集鍵選擇、NULL 約束、拆分策略、填充因子) 都在為未來效能「寫基因」。事後調優成本是設計階段的 10~100 倍。養成「以查詢模式反推設計」的習慣:先寫核心查詢 → 分析存取路徑 → 定義索引/分區/約束 → 再建表。